
stablediffusion的风格训练与人物训练
本文目录
大家好,我是SD中文网的站长小庞。Stable Diffusion 的风格训练,是让模型学会一套配色、线条和构图习惯;人物训练则是让它记住同一个人的脸和体态,换姿势、换衣服还能认出来。现在主流做法不是重训整个大模型,而是训一个小小的 LoRA——可以把它想成给底模贴一张便利贴,只补一项新本事。数据集质量通常比参数更重要,底模一般用 SDXL 模型介绍和下载;完全不想碰训练工具的新手,直接用 助澜AI创作台免费下载 出图会更省事。
风格训练和人物训练,到底训的是啥
Checkpoint 像一本完整教材,LoRA 只是夹进去的一张笔记。人物 LoRA 学的是“这是谁”,风格 LoRA 学的是“这张画画起来像哪一路”。两者用的工具差不多,数据集思路完全相反:人物要极致统一,风格要故意打散主体。

| 对比项 | 人物训练(角色 LoRA) | 风格训练(画风 LoRA) |
|---|---|---|
| 目标 | 同一张脸、同一套体态能稳定复现 | 配色、线条、构图、抽象程度能迁移到各种题材 |
| 图片数量(常见) | 20~50 张高质量图,宁少勿滥 | 一般 100 张起,常见到 400 张以上 |
| 多样性 | 人必须一眼能认,姿势、光线、服装尽量变 | 主体、背景、物体都要杂,别让某个角色抢戏 |
| 步数(SDXL,大致) | 大约 1500~3000 steps | 大约 8000~10000 steps |
| 触发词 | 专用词,如 mycharacter | 如 in the style of TOK,别跟某个角色绑死 |
社区里有一份写得很细的 SDXL 人物 LoRA 数据集指南,核心就一句话:每张图必须毫不含糊是同一个人。风格这边则相反,单一角色出镜太多,模型会把“某个人”误当成“这种画风”。
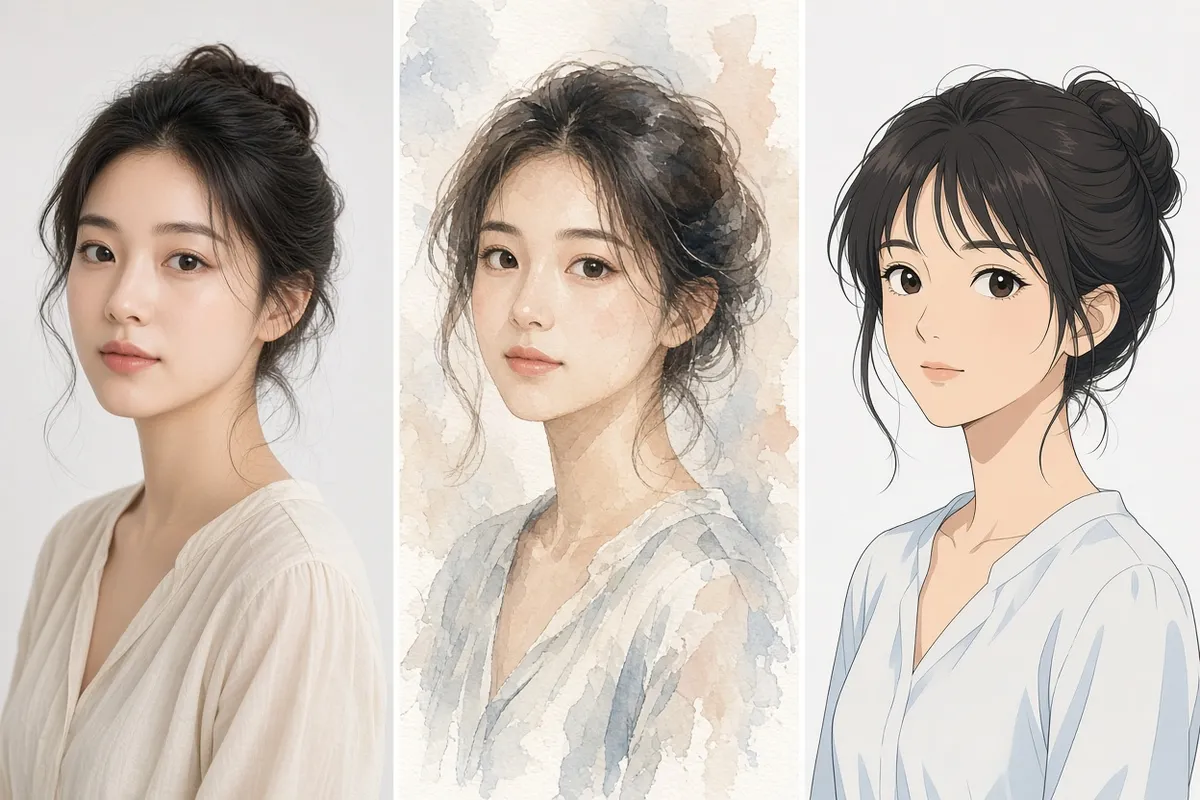
数据集怎么准备才不白训
自动打标(BLIP、WD14 这类)可以当草稿,但一定要人工过一遍 .txt。触发词要统一,人物外貌写清楚,风格则把“像谁的画”写进标签,别让风格偷偷粘在某张脸上。旧文里说的镜像翻转现在还能当小补充,但只靠左右翻转撑不起一个 LoRA。
- 人物:先定一张“标准脸”,再补侧面、半身、全身、室内室外、不同衣服;20~30 张干净图,往往比 50 张含糊图更稳。
- 风格:风景、静物、群像、特写都要有,主角不要刷屏;一张图里风格特征要看得着,主体却不能总是同一个人。
- 分辨率:SDXL 常见 1024;模糊、重影、水印、乱入路人的图直接丢掉。
- 正则化图(class prompt 生成、不带触发词的图)可以减轻过拟合,数据很少时再考虑,不是必须上。
- 用临时模型狂造假图再丢回去训,容易把错误放大,只适合补几个缺的角度,不能当主力数据。
想自己训的话,软件和步骤怎么选
第一次用 AI、只想尽快出图出视频,别一上来就装训练套件,先打开助澜AI创作台更合适。已经要玩节点和工作流、还想跟上新模型的,用 ComfyUI 下载和安装教程。秋叶 WebUI 适合已经习惯那套界面和插件的老用户,原版更新很慢,较新的模型一般还是得去 ComfyUI。电脑没有 N 卡、显存不够、Mac 或轻薄本,训练本地基本劝退,生图可以先用 咕嘟AI在线生图生视频,打开网页就能用。
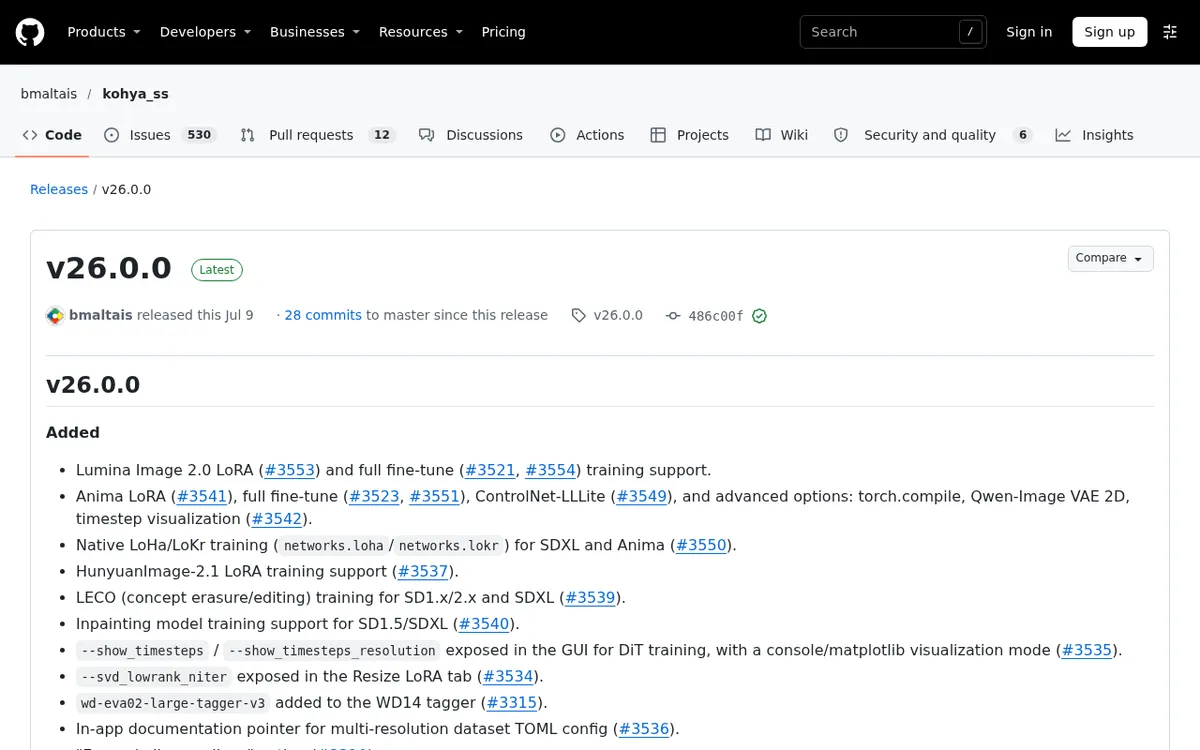
本地训 LoRA,社区用得最多的是 kohya_ss。截至 2026 年 11 月,kohya_ss 稳定版是 2026 年 7 月 9 日的 v26.0.0,底层 sd-scripts 在 2026 年 10 月 26 日到过 v0.12.3。请走 GitHub 正规渠道,别下来路不明的魔改包。
- 准备底模:SDXL 的 LoRA 只能给 SDXL 及衍生模型用;SD1.5 的 LoRA 不能丢进 SDXL。底模和以后出图用的模型尽量同一路。
- 把图片和对应 txt 放进训练文件夹,触发词写进每一条标注。
- 从 kohya_ss 最新版本发布页 按官方说明安装,Windows 一般是 setup 后开 gui。
- 选对应脚本(SDXL LoRA),分辨率 1024,打开 cache latents,batch 先设 1。
- 每隔一段保存一次,拿中间文件去出图测试,别傻等训完才看。
- 得到 .safetensors 后,放进软件的 LoRA 目录,提示词里加上触发词,权重常从 0.6~1.0 试起。
参数怎么选,显存不够怎么办
超参数没有万能表,只能当起点。人物更怕身份漂,风格更怕步数不够或数据太偏科。SDXL 在 1024 上训 LoRA,显存峰值常见要到十几 GB,12GB 比较从容;8GB 能挤,但得把省显存的开关全打开。
| 项目 | 人物 LoRA(SDXL,常见起点) | 风格 LoRA(SDXL,常见起点) |
|---|---|---|
| 网络尺寸 rank / dim | 16~32 | 16~64 |
| alpha | 常取 dim 的一半,或 16~32 | 同样先跟 dim 对齐再微调 |
| UNet 学习率 | 1e-4 或更低 | 大约 1e-4 |
| 文本编码器学习率 | 通常约为 UNet 一半 | 常见 5e-5 左右 |
| 调度 | cosine 很常用 | cosine |
| 显存 | SDXL 建议 12GB 以上;SD1.5 大约 6~8GB 也能训 | 同左,图更多、步数更长,风扇会叫得更久 |
显存爆了就:batch_size=1,打开 gradient checkpointing,把 latents 缓存到硬盘,用 8bit AdamW 或 Adafactor,必要时降低 rank。老卡可以试 fp16。很多人一上来把步数拉满,模型把训练图背下来了,换个动作就崩——这叫过拟合,中间多存几个文件、出图对比一下最管用。没有独显就别硬训,生图改走咕嘟或助澜,少走三天报错的弯路。
常见问题
人物换个姿势脸就飘,是不是参数没调好?
多半是数据里混进了“看起来像、其实不是同一人”的图。先把图筛到每张都认得出,比把学习率再往下拧两档更有效。20 张干净图,通常好过 50 张含糊图。
风格 LoRA 一出图就总是那两个人物怎么办?
训练集被某个角色带偏了。补一批没人的风景、物件、群像,给常客单独打标签,生成时把他们写进负向提示。风格要的是画法,不是固定主演。
训好的 LoRA 几乎没效果,或一加载就花屏?
先查底模是不是对上了:SDXL 的 LoRA 不能给 SD1.5 用。再看触发词有没有写、权重是不是太低。花屏、结构崩,常见是过拟合或 rank 过大,换更早的保存点,把权重降到 0.5~0.8 试试。
WebUI 里能用这些 LoRA 吗?新模型呢?
能。已经习惯秋叶 WebUI 的,把文件放进 LoRA 文件夹即可。WebUI 原版大约停在 2025 年 2 月的 v1.10.1,后面基本不更了,Flux、Qwen-Image 这类较新的模型更建议在 ComfyUI 里用。
风格训练盯的是画法,人物训练盯的是身份,两者都靠 LoRA 这张“便利贴”,真正拉开差距的是数据集而不是把学习率精确到小数点后八位。先定你要的是一张脸还是一路画风,再按上面的表准备图和步数;只想出图不想训模型,就用助澜AI创作台。训翻车了把报错丢到 本站交流群,大家一起看。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/sd/sd-knowledge/576.html



