
ComfyUI做AI漫剧的提示词与工作流
本文目录
大家好,我是SD中文网的站长小庞。ComfyUI做AI漫剧,核心就两件事:把角色提示词写成一套几乎不变的「固定台词」,再配一条「锁脸→锁姿势→出分镜→再让画面动起来」的工作流。提示词里发型、服装、五官要逐词重复,工作流通常用角色参考图加IPAdapter锁人物、ControlNet锁动作,分辨率固定成竖屏短剧尺寸,这样连续几格才不像换人演。完全没碰过本地AI、只想先出几张分镜的,别一上来啃节点,先用助澜AI创作台免费下载和上手说明更快;想自己控每一格构图,再上ComfyUI。
漫剧提示词怎么写才不跑脸
可以把提示词想成给演员的「造型说明书」。Checkpoint像整本画册的底子,决定大风格;LoRA像贴在脸上的贴纸,负责某个角色或某种网点;提示词则是你每次喊的那几句固定台词。台词一变,脸就漂。
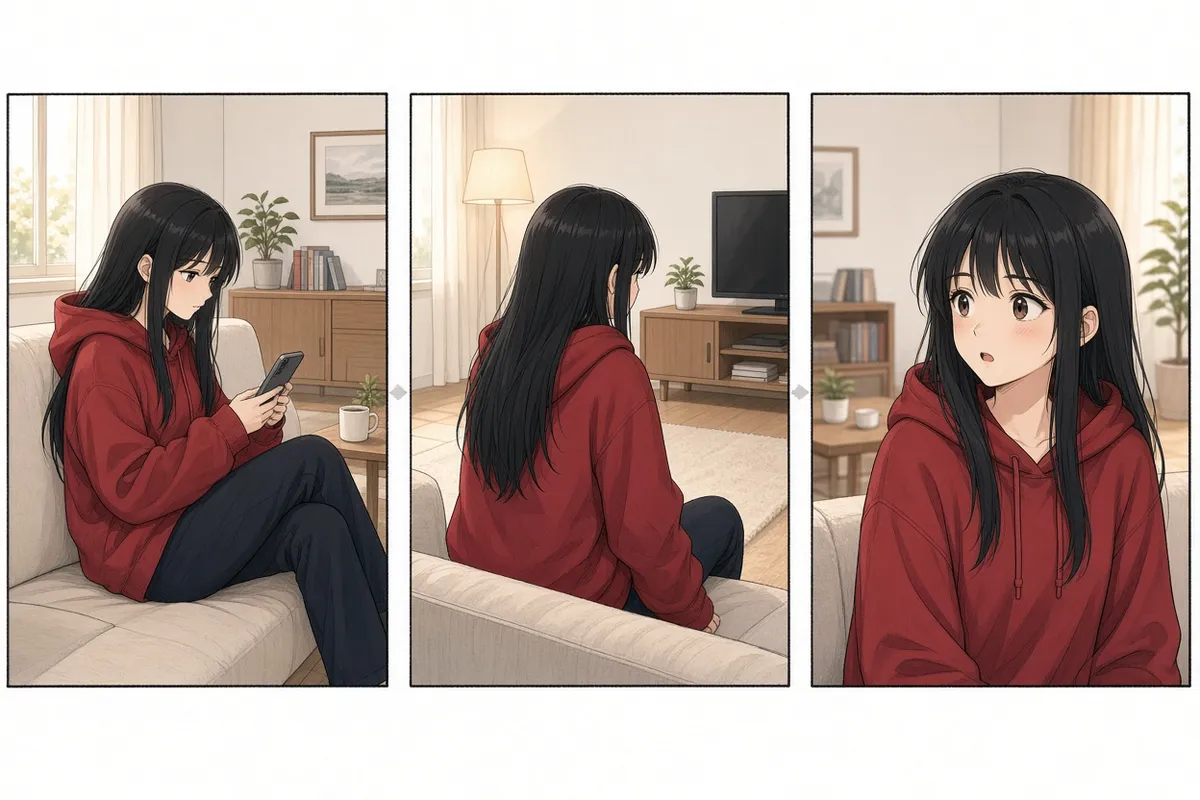
写漫剧提示词,我建议拆成四段,每格分镜只改「这一格在干什么」,前面三段尽量一字不动:
- 画风锚点:vertical comic, 9:16, comic panel, smooth coloring。要黑白页就改成 monochrome, greyscale, manga, screentone。
- 角色锚点:把头发长度、颜色、刘海、眼睛、衣服颜色和款式写成固定短句,正反提示里都别改词。比如「1girl, long black hair, straight bangs, red hoodie」,下一格还是这句,不要写成「黑长直、红卫衣」这种中英混着换词。
- 场景锚点:地点和光线固定,比如 home living room, soft lighting。换场再换这一段,不要每格都重新发明一个房间。
- 这一格动作:只写当前分镜,例如 looking at phone, surprised, half body。动作可以变,五官描述不要变。
负向提示词建议长期复用这一组:lowres, bad anatomy, deformed, blurry, disfigured, changing facial features, low quality, watermark。做黑白漫画时,负向里再加上 color,减少突然上色。
很多人一上来就把节点拖了一屏幕,结果脸每张都不一样,其实问题多半出在提示词没锁住。同一集里角色描述复制粘贴,比你再装三个插件都管用。需要多表情时,准备2到4张参考图(正面、侧面、高兴、生气),比在提示词里临时加「smiling」更稳。
分镜工作流按什么顺序连
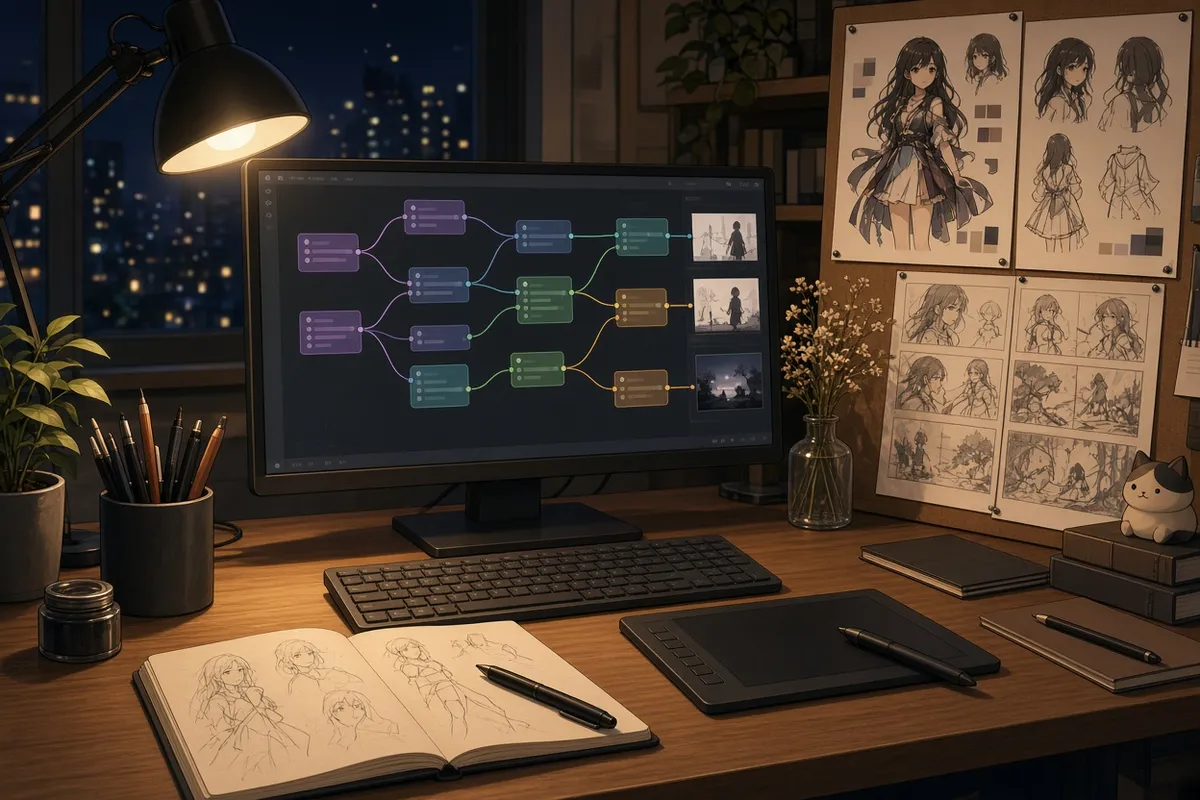
工作流就是流水线,节点是流水线上的工位,线是传送带。漫剧这条线别绕成蜘蛛网,按下面顺序走就够用。节点怎么连、线从哪头拖,可以对照ComfyUI工作流怎么连接的图文说明,这里只讲漫剧这条线该怎么排。
- 先用大模型或你自己列一份分镜表:每格一句场景、一句对白、几个角色出镜。这一步在ComfyUI外面做完再进画布,省得边生成边改剧本。
- 加载角色参考图。IPAdapter可以理解成「把这张脸的味道抹到后面每张图上」,连续分镜权重一般放在0.65到0.85,常用0.75。太高会像复印,太低又换脸。
- 加ControlNet。OpenPose锁肢体,LineArt锁轮廓和分镜构图,强度都别拉满,小于1.0。双控比单控更能管住「手变成鸡爪、构图每格乱跳」。
- 用动漫向的Checkpoint或Flux系模型出静帧分镜。竖屏短剧常用576×1024,横屏对白页可用1024×576,同一集里分辨率不要变来变去,风格最容易漂。
- 静帧过关后,再进图生视频。社区里常见是接VideoHelperSuite,或AnimateDiff、LTX、Wan 2.2模型介绍和下载这类视频模型。运动幅度 motion_scale 建议0.3到0.5,漫剧要的是微动态,不是整个人扭成另一张脸。
- 对白气泡、分镜格、阅读顺序,可以用专门的漫画页节点包来排。社区里有PH3-Manga这类方案,能从多种预览布局里选2到6格、挂最多3张角色参考、再改气泡尾巴。没有这类节点也行,先出单格再后期拼页,别为了排版把主流程搞崩。
种子(seed)跨帧尽量固定。种子像抽卡编号,同一套提示词换编号,五官就会微调。批量出分镜时,提示词放进文本列表循环提交,比你在画布上点一百次Queue省事。
参数和模型怎么选才稳
漫剧不是一张海报,是几十格要长得像一家人。参数宁稳勿猛。截至2026年11月,本站提供的ComfyUI官方桌面版正式版是v1.1.9(2026年11月6日),桌面版里的ComfyUI核心可以单独更新到v0.45.0(2026年11月10日)。装软件、看系统要求,走ComfyUI官方桌面版下载和安装教程,模型请走本站或官方正规渠道,别信「永久免费、绝对安全」那种来路不明的包。
| 项目 | 建议 | 备注 |
|---|---|---|
| 画面比例 | 576×1024(9:16)或1024×576 | 同一集固定,减少风格漂移 |
| IPAdapter权重 | 0.65–0.85,连续分镜常用0.75 | 超过约0.8容易僵、完全复刻参考图 |
| ControlNet强度 | 小于1.0 | OpenPose管动作,LineArt管线稿和构图 |
| KSampler | Steps 30,CFG 7 | 先求稳定,再微调步数 |
| 视频运动 | motion_scale 0.3–0.5 | 微动态,避免五官变形 |
| 显存 | 量化模型时约8GB也能跑 | 更舒服是12GB以上;模型本身还要另留几GB到几十GB硬盘 |
模型怎么配:静帧用动漫Checkpoint或Flux系;锁脸用IPAdapter-FaceID;姿势和线稿用OpenPose、Lineart;视频用Wan、LTX或MiniMax H3这类。黑白网点可以加screentone风格的LoRA。显存像你书桌大小,模型是摊开的图纸,桌子不够就换小图纸(FP8、GGUF量化),别一股脑把所有自定义节点都装上。
电脑没有N卡、显存不够、Mac或轻薄本跑着费劲,或者根本不想装环境的,用咕嘟AI在线生图生视频就能先出分镜和短视频,不用显卡、打开网页就能试。本地ComfyUI适合愿意花时间调节点的人;已经习惯秋叶WebUI界面的老用户可以继续用WebUI出静帧,但较新的模型和视频链路,还是ComfyUI跟得上。
角色跑脸、显存爆了怎么办
跑脸:补齐2到4张参考图进IPAdapter,权重先回到0.75,种子固定,再叠加OpenPose。还漂,就给这个角色单独做或选用角色LoRA,比你在提示词里加十个「same face」有效。局部五官崩了,用inpaint修一张,别整集重抽。
肢体畸形、构图不齐:检查是不是只开了文生图、没开ControlNet。双控(姿势+线稿)加上负向里的bad anatomy, deformed,大多数鸡爪能压住。分辨率中途改过的,先改回去再比。
画风不统一:IPAdapter别高于大约0.8,同一集用同一个Checkpoint、同一条LoRA、同一句画风锚点。黑白页正向写 monochrome, manga, screentone,负向写 color。
8GB显存报OOM:换量化模型、batch改1、减少同时开着的自定义节点。桌面版或启动项里限制显存占用(资料里常见的做法是把gpu-memory限制在7.0左右),仍不够就改用咕嘟AI在线出,别跟电脑死磕。
工作流拖进去一片红:缺的是自定义节点,不是提示词写错。缺哪个装哪个,装完重启。JSON工作流文件放哪、怎么复用,别跟模型文件夹混在一起,模型路径就像厨房里食材该进冰箱,工作流是菜谱,菜谱别扔进冷冻层。
常见问题
提示词用中文还是英文?
角色和画风锚点建议用你模型更吃的那一套,很多动漫模型和漫画页节点对英文短句更稳;对白可以中文。同一集里中英不要来回翻译同一件衣服,换词等于换造型。
一定要上视频节点吗?先出静帧行不行?
行,而且我更建议新手先把静帧分镜跑稳。脸和构图不过关,后面图生视频只会把错误放大。静帧过关再接微动态,比一上来就出片省很多返工。
IPAdapter和角色LoRA要一起用吗?
短镜头、角色少,参考图加IPAdapter通常够了。角色要跨很多集、表情服装都多,再加角色LoRA更省事。两者一起用时权重都往低处收,避免脸被锁死成一张贴纸。
没有独立显卡还能做漫剧吗?
Windows版ComfyUI不强制独显,但会非常慢。Mac桌面版需要M1及以后的苹果芯片、macOS 13及以上。只想马上看到分镜,用咕嘟AI在线做更实际。
记住:漫剧提示词是「锁定造型的固定台词」,工作流是「锁脸、锁姿势、固定分辨率、最后再微微动起来」。先把一格写对、再复制到整集,比追求一次生成二十格更靠谱。想自己搭节点就装ComfyUI;想少折腾、先做出带画面和声音的片段,用助澜AI创作台更合适。卡住了进本站交流群和同行一起问配置,把电脑配置和想做的漫剧类型发一下,比自己猜参数快。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/sd/26194.html



