
AI漫剧分镜提示词模板怎么套
本文目录
大家好,我是SD中文网的站长小庞。AI漫剧分镜提示词模板怎么套,其实就三步:每条提示词开头先贴同一张角色卡,中间按“这一镜要干什么—在哪—怎么动—用什么景别和光”填肉眼能看见的细节,结尾锁死画风和负面限制,再整段丢给生图工具。别写“气氛紧张”“很有电影感”这种空话,只写人坐哪、手往哪伸、光从窗户哪边打进来。完全没接触过、只想快点出分镜图的,用助澜AI创作台下载和上手说明粘进去就能出图;电脑没独显、用Mac或懒得装的,直接打开咕嘟AI在线生图生视频也行。
单镜头模板按这个顺序填
提示词可以把它想成给画师的拍摄说明书:你不说清楚机位和道具,对方就只能瞎猜。社区里比较好用的单镜头结构,建议按下面顺序填,填完再微调,不要东一句西一句。
| 填哪一块 | 写什么 | 别写成这样 |
|---|---|---|
| 镜头编号 | S01、S02,方便对表 | 随便起名、和不对号 |
| 剧情任务 | 这一镜要交代的一件事 | 把整集剧情全塞进去 |
| 固定角色卡 | 外貌、发型、服装、标志物,每条都原样粘 | 这镜写短发、下镜写成披肩发 |
| 场景环境 | 室内外、时间、道具、前后景 | 只写“咖啡馆” |
| 动作与情绪 | 一个主要动作 + 脸上能看见的表情 | “内心挣扎”“情绪爆发” |
| 景别与构图 | 特写/近景/中景/全景,机位高低,竖屏9:16 | 不写景别,或连着好几镜都中景 |
| 光线与色调 | 光从哪来、冷暖、是否有丁达尔、黄金时刻 | 只写“好看的光” |
| 画风 + 负面 + 用途 | 国漫线稿细腻上色等;不要换脸、畸形、多余手指;注明给分镜图还是图生视频 | 画风每镜换一套 |
还有个更短的万能公式,赶时间就套这个:画面主体(具体到衣服褶皱、手里杯子)+ 镜头语言(景别+机位)+ 环境光影 + 情绪氛围(仍要用可见细节)+ 画风。主体和情绪放最前,镜头和质感放后面。竖屏短剧在提示词里写明“竖屏9:16”,一个镜头只写一个主要动作,后面拿去图生视频才不容易拧巴。
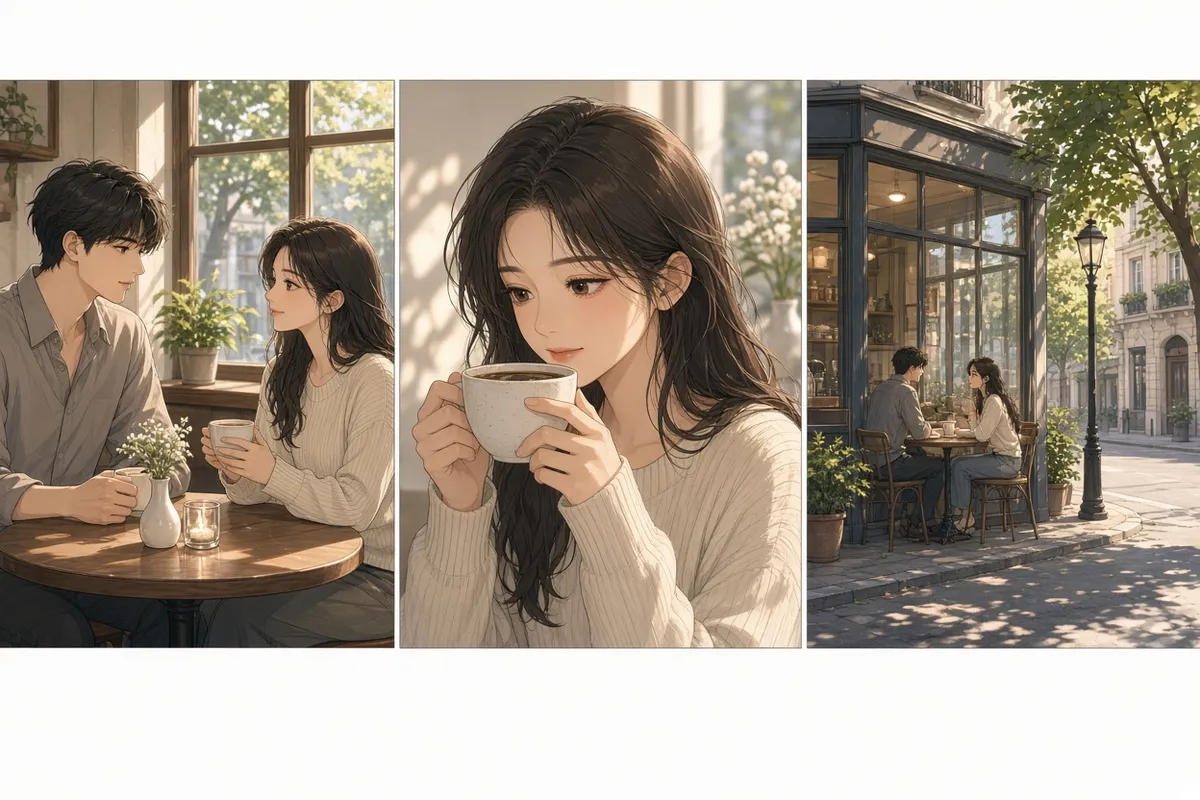
双人对话中景可以直接改这一段用:竖屏9:16,现代都市漫剧,清晰线稿,细腻上色,[此处粘完整角色卡],室内咖啡馆,午后阳光从左侧落地窗打进来,两人面对面坐着交谈,中景,固定机位,柔和自然光。负面:人物脸型改变,肢体畸形,多余手指,画面模糊。情绪冲突就改成近景特写、悬念用大全景,结构别动,只换动作、景别和光。
三种套用法,挑一种就够
第一种最省事:网页上改现成模板,改完复制,粘到绘图工具或分镜表。适合单镜头、剧本转分镜、情绪镜头、动作镜头这几类,有的页面还带“恢复模板”“复制内容”。你改的是空位,不是整段重写。
第二种最适合已经有剧本的人:先让大模型按固定字段吐表格,再逐行拼成生图提示词。字段建议锁死为镜号、画面描述、台词或旁白、音效或配乐、单镜时长,不要让它自己加列。硬性规矩可以写进给大模型的说明里:单集约30秒,开篇前3秒要有强看点,画面描述必须具体到能直接丢给生图模型,单镜时长1到5秒,相邻镜头不要同景别重复,每3到5镜至少变一次景别,避免跳轴,画面里不要出现中文字。跳轴就像两个人对话时,你突然把左右位置对调,观众会觉得人瞬移了。
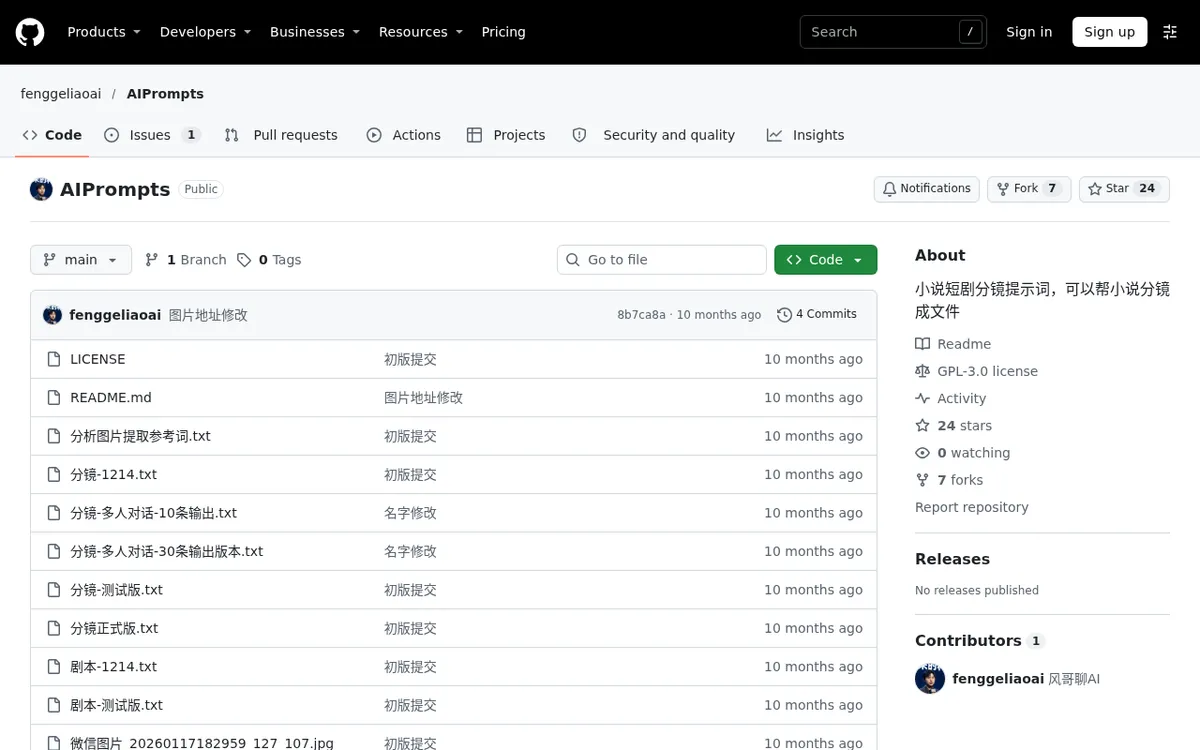
第三种是下现成 txt / md 当骨架。截至2026年11月,开源仓库里能直接拿来改的有:GitHub 上的分镜提示词 txt 模板(含正式版和多人对话版),里面有《分镜正式版.txt》《分镜-多人对话-30条输出版本.txt》这类文件,强调用固定逻辑框住角色 ID,不同景别也尽量把脸稳住;仓库标明 V1.0 稳定版,部分提示词来自“道格”、并非全部原创,不要拿去商用。另一份是YubAI-DramaFlow 的分镜表模板(templates 文件夹可下 ZIP),跟智能体一起用,不用额外装环境。下载走 GitHub 正规页面,别信来路不明的“永久免费合集”。
分镜表怎么拼成一条能出图的提示词
表格只是分镜导演的草稿,生图模型看不懂表格。角色卡就像身份证复印件,每一镜都要重新贴一遍,模型没有“上一镜我记住了”这种记性。拼的时候按下面做:
- 从剧本或节拍里生成表格,一镜只写一个主要动作;新场景先用全景交代环境,对话和情绪多用近景特写,画幅写竖屏9:16。
- 把某一行的画面描述拷出来,前面粘完整角色卡(外貌、发型、服装、随身物一次写全)。
- 补上这一镜的景别、机位、光线色调,不要和上一镜完全一样。
- 结尾固定画风和质量词,例如国漫风格、细腻上色、高细节、电影质感;再加负面:不要换脸、不要肢体畸形、多余手指、画面模糊、人物脸型改变。
- 如果后面要图生视频,画面描述里只留一个运动方向,比如缓慢推镜或轻微跟镜,不要又推又绕又升。
想把分镜和工作流抠得很细、自己串节点的,再用ComfyUI 下载和安装教程。节点可以想成流水线上的工序卡:一张卡管出图,一张卡管锁脸,别一上来就搭几十个卡。本地显存不够、装到一半报错的,别死磕,回到咕嘟AI网页出图更省事。出完分镜图再进视频时,同一模型、同一套角色描述接着用,角色才不容易换脸。
套用时最容易翻车的几件事
- 角色跨镜换脸、换衣服:每条提示词开头必须复用同一段完整角色描述;有参考图就用参考图,进阶再上 ControlNet、IP-Adapter 或 Character ID。同一套模型、能锁种子就锁。
- 抽象词无效:把“悲伤”改成“眼眶发红、嘴角下压、手指攥紧杯柄”;把“紧张”改成“肩膀耸起、目光盯着桌面”。
- 一镜里动作太多:生图还能凑合,图生视频必变形。一条镜头一个主动作、一个运动方向,前景中景背景拉开一点视差就够,别用 zoom 冒充推镜。
- 景别不换、叙事发闷:情绪高潮用特写,换场用全景,每3到5镜变一次景别;相邻镜头动作和视线方向要对上,不然看起来人会突然转身那种别扭。
- 画幅和文字:竖屏短剧写死 9:16;不要让画面里长出中文字、字幕、水印。
工具侧,分镜静帧用常见文生图就行,后续运动可以接到可灵、Seedance、Runway、Pika 这类;视频提示词同样只给一个方向。没有 N 卡、轻薄本跑不动本地的,分镜静帧和短视频都可以先在咕嘟AI上试,确认模板套对了再考虑本地。
常见问题
角色卡写一次,后面几镜能省略吗?
不能。模型几乎不记上一镜的人设,省略之后最常见的就是换脸、换发型、换衣服。正确做法是整段复制粘贴,只改这一镜的动作、景别和光,角色段一个字都别动。
套了模板还是出残手、多人粘在一起怎么办?
先检查是不是一镜里塞了好几个动作,再把负面提示写全:肢体畸形、多余手指、人物脸型改变。双人镜头写清谁在左谁在右、视线看向谁,比写“两人互动”管用得多。
大模型吐出来的分镜表能不能直接当生图提示词?
不能直接扔。表里的“画面描述”只是半成品,必须加上固定角色卡、画风后缀、质量词和负面提示。若描述里还有“氛围压抑”这种抽象词,先改成看得见的道具、光线和表情,再拿去出图。
GitHub 那些 txt 能商用吗?
以仓库说明为准。上面提到的分镜 txt 模板标了部分内容非原创、切勿商业使用,个人学习改着用可以,拿去接商单或二次售卖不行。下载只走官方仓库页面,不要用来路不明的网盘包。
套模板不是把范文整段复制,而是锁死角色、锁死填写顺序、锁死一镜一动作,再把表格翻译成模型听得懂的画面。建议你先拿一场双人对话、按中景那条改出 6 到 8 个镜头试一遍,角色稳了再加特写和运镜。有卡住的地方,欢迎加入本站交流群一起聊分镜和提示词。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/aist/26181.html



