
ComfyUI提示词节点怎么接CLIP
本文目录
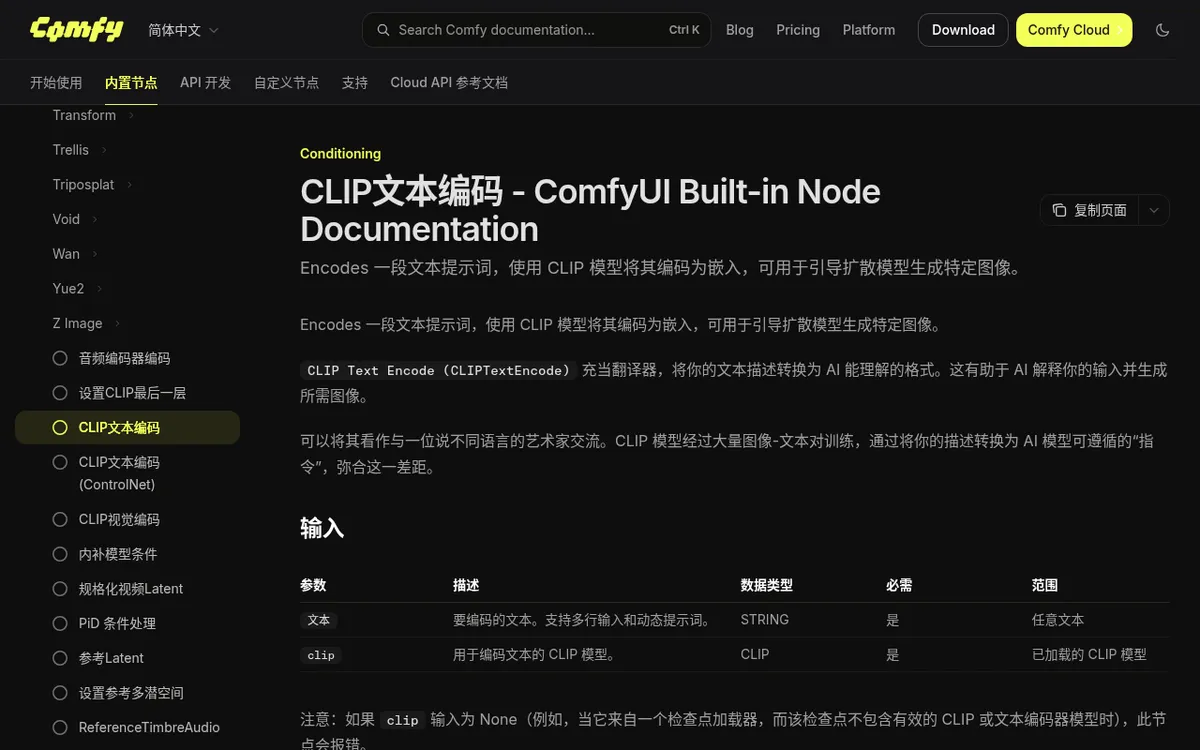
大家好,我是SD中文网的站长小庞。ComfyUI 里提示词节点(CLIP Text Encode)要先接上 CLIP,才能把你写的话变成模型能听懂的信号:最常见是把 Load Checkpoint 的 CLIP 输出,直接拖到 CLIP Text Encode 的 clip 口;Checkpoint 里没有文本编码器、或者像 Flux、SD3 这种要单独加载的,就用 CLIPLoader(或 DualCLIPLoader)把编码器读出来再接到 clip。编码完的 CONDITIONING 接到 KSampler 的 positive / negative。没接、接错、type 选错,就会报 CLIP is None,或者提示词几乎不生效。
最常见的接法:从 Checkpoint 把 CLIP 拉过来
你可以把 Checkpoint 理解成一盒打包好的午餐:里面通常有负责画画的模型、负责把文字翻译成向量的 CLIP,有时还有 VAE。提示词节点自己不会“认字”,它只是翻译器,字典必须从外面接进来。标准链路就是:Load Checkpoint 的 CLIP → CLIP Text Encode 的 clip → 输出 CONDITIONING → KSampler。
正负提示词要各用一个 CLIP Text Encode,两个节点的 clip 都接到同一根 CLIP 上,positive 连采样器的正面,negative 连反面。text 口直接打字,支持多行,也支持 embedding:文件名、以及 (word:1.3)、((word)) 这类权重写法。这个节点是 ComfyUI 核心自带的,不用单独装,从第一天就在,类别在 conditioning 里。
- 双击空白处搜 CLIP Text Encode(Prompt),拖两个出来,一个写正面,一个写反面。
- 从 Load Checkpoint 的 CLIP 输出拉线,分别接到两个提示词节点的 clip。
- 两个节点的 CONDITIONING 输出,接到 KSampler 的 positive 和 negative。
- 确认线上没有断、颜色对得上,再点 Queue 出图。
想自己搭节点、追新模型的,用 ComfyUI 没问题,安装和更新可以看本站的 ComfyUI 下载和安装教程。要是你完全没碰过本地 AI,只想快点出图、出视频、出音乐,别一上来就啃节点,先用本站的 助澜AI创作台下载页,环境不用自己搭,打开就能生成。
Checkpoint 没 CLIP 时,用 CLIPLoader 单独加载
有些模型包得不完整,或者 Flux、SD3、Lumina2 这类架构,文本编码器是分开放的。这时 Load Checkpoint 的 CLIP 是空的,硬接会报 checkpoint may not contain a valid CLIP or text encoder model。解决办法是加 CLIPLoader(SDXL / Flux 常用 DualCLIPLoader),选对文件和 type,再把 CLIP 输出接到提示词节点的 clip。
编码器文件放到 ComfyUI/models/text_encoders/ 里(老目录 models/clip/ 一般还能被认出来),重启或点 Refresh,下拉里才能看到。type 必须跟模型家族对上,选错了不会每次都红字报错,但提示词会变的很怪,甚至完全没作用。
| 你在用的模型 | CLIP 从哪接 | type 大致怎么选 | 提示词节点建议 |
|---|---|---|---|
| SD 1.5 一类经典模型 | Load Checkpoint 的 CLIP | 一般不用单独加载;独立加载时用 stable_diffusion(clip-l) | CLIP Text Encode |
| SDXL | Checkpoint 或 DualCLIPLoader | clip-l + clip-g | 优先 CLIP Text Encode (SDXL) |
| Flux | DualCLIPLoader / CLIPLoader | flux(t5xxl + clip_l) | 优先 CLIPTextEncodeFlux |
| SD3 | 多编码器加载 | t5xxl / clip-g / clip-l | 按工作流用对应编码节点 |
| Lumina2 及 2026 年一批新模型 | CLIPLoader | lumina2 用 gemma2;另有 qwen3-vl、llama-3.1 等 | 跟工作流配套的编码节点 |
截至 2026 年 11 月,官方文档对 CLIPLoader 的 type 说明刚更新过(大约 11 月 11 日),ComfyUI 建议跟到 v0.45.x(v0.45.3 大约 11 月 12 日前后),新编码器类型才比较齐。节点输入输出以 CLIP Text Encode 官方说明 和 CLIPLoader 官方节点页 为准,下载编码器走官方或本站正规渠道,别随便下来路不明的包。
SDXL、Flux 不要只用普通那一个提示词节点
普通 CLIP Text Encode 只有一个 text 框,遇到双编码器时,等于把同一段话同时塞给两个编码器。SDXL 更合适的是 CLIP Text Encode (SDXL),有 text_g、text_l,还能带尺寸相关的 conditioning;Flux 更合适的是 CLIPTextEncodeFlux,clip_l 和 t5xxl 分开写。接 CLIP 的方式没变,还是 Loader 的 CLIP 进 clip 口,只是输入格子变多了。
还有两件容易忽略的事。经典 CLIP 大概只能吃 77 个 token,写太长会被截断,可以在提示词里插 BREAK 分块,或者多个 CLIP Text Encode 再加 Conditioning 合并。T5-XXL 这类大家伙很吃显存,笔记本、核显、Mac、显存不够的机器本地会很吃力,这种时候别死磕,用 咕嘟AI 在线生图生视频 打开网页就能出,不用装环境也不用独立显卡。
2026 年不少新模型改用 Gemma、Qwen、Llama 这类编码器,以前那套 tag 堆砌加权重,效果会弱很多,更适合写成完整的自然语言句子。权重语法不是万能钥匙,字典换了,说话方式也得换。
接错了怎么查,线到底有没有通
报错最常见就两类:clip 口是空的,或者 type 跟模型不是一家。你可以把整条链路当成“字典 → 翻译 → 画师下笔”,任何一截断了,后面都是瞎画。
- CLIP is None / invalid CLIP:检查 Checkpoint 是否真的带了文本编码器;没有就改 CLIPLoader,文件放到 text_encoders 目录后再 Refresh。
- 提示词几乎不起作用:先看 CLIPLoader 的 type 是否匹配;再看是不是在 LLM 编码器上还在堆老式 tag。
- 线颜色对不上、拖不过去:输出是 CLIP 才能进 clip,CONDITIONING 只能进采样器或 ControlNet 的条件口,别接反。
- 超长提示后半段消失:碰到 77 token 限制,用 BREAK 或 Cond 合并,不要指望一个框塞一篇作文。
基本连接不需要额外装自定义节点。只有你特别想贴近 A1111 那种权重算法时,才考虑用 Manager 装兼容节点,新手先把这根 CLIP 线接明白更重要。
常见问题
正负提示词要不要接同一根 CLIP?
要。两个 CLIP Text Encode 的 clip 都接到同一个 Checkpoint 或同一个 CLIPLoader 上,只是 text 内容和接到 KSampler 的正负口不同。各接各的编码器,正负条件就不在同一个语义空间里了。
只用 Load Checkpoint,还要不要再加 CLIPLoader?
Checkpoint 里已经有有效 CLIP 时,直接用它的 CLIP 输出就行,再加一个容易乱。只有 CLIP 为空、或者官方工作流要求独立编码器时,才上 CLIPLoader,并且 type 按模型家族选。
节点红了,提示 checkpoint 里没有 CLIP,怎么办?
别在 Checkpoint 上死磕。改用 CLIPLoader 加载 text_encoders 目录里的 clip_l、t5xxl 等文件,type 选对,再把 CLIP 接到提示词节点。仍报错的话,先确认 ComfyUI 已经更新到较新的 v0.45.x。
Flux 接了普通 CLIP Text Encode 能不能出图?
有时能出,但不稳,也浪费了双编码器。Flux 把同一段话塞进普通节点,等于没把 clip_l 和 t5 分开说话,优先换成 CLIPTextEncodeFlux,CLIP 仍然从 DualCLIPLoader 那根线进来。
提示词节点接 CLIP,核心就三步:找到匹配的 CLIP(Checkpoint 或 CLIPLoader)、接到 clip 口、把 CONDITIONING 交给采样器。线通了、type 对了,提示词才算真正进了模型。第一次玩节点别急着上很复杂的工作流,先把这一根线接顺;不想折腾环境的,直接用助澜AI创作台出作品。接线时卡住了,可以加入本站交流群把工作流截图发出来,大家一起帮你看。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/sd/26158.html



