
ai绘图提示词模板去哪找?提示词库怎么用?
本文目录
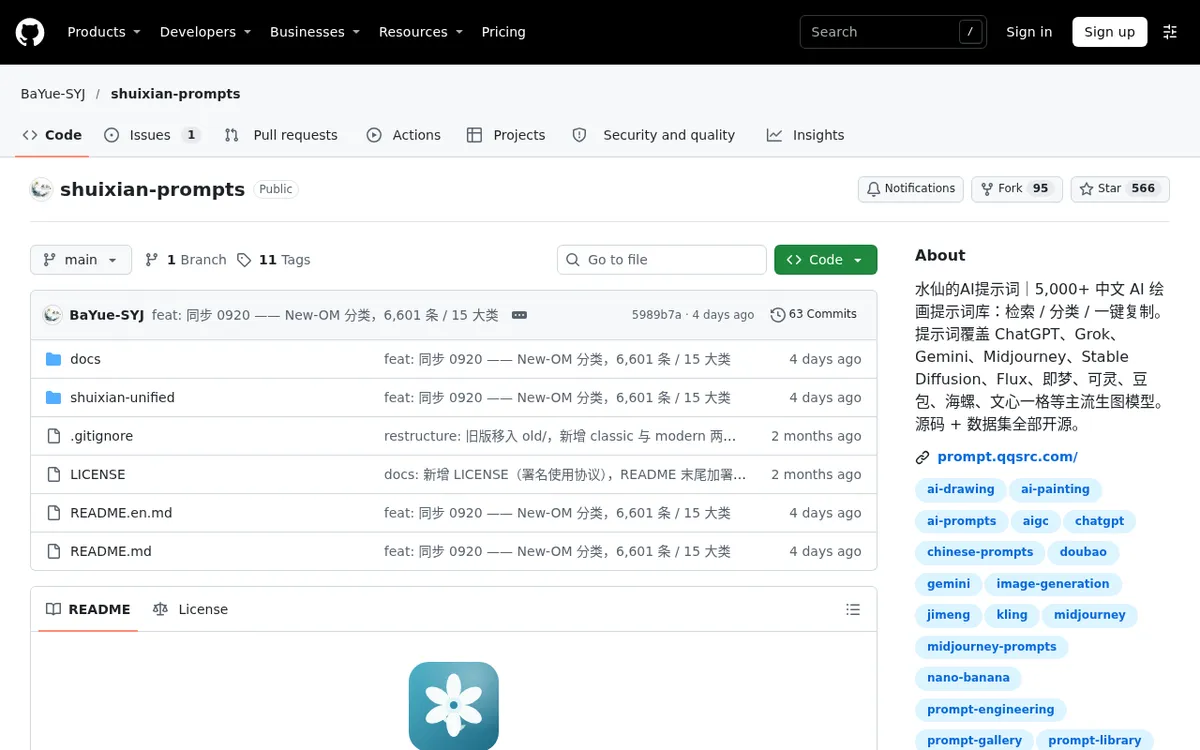
大家好,我是SD中文网的站长小庞。ai绘图提示词模板和提示词库,不用自己从零编:中文最全的开源库可以去水仙(GitHub 上开源了数据和分类,大约 6601 条、15 大类 79 细类),综合库可以看 NavXD(截至 2026 年 11 月 16 日约 7235 条,含生图、视频和 MJ 风格码)以及 imageprompts.co 这类经过真实出图筛选的库。用法很简单——按分类或关键词搜、对照效果图、一键复制,再按你实际用的模型改主体和风格,别原文硬贴。完全没接触过、只想快点出图的,直接用本站助澜AI创作台免费下载更省事;没独显、Mac 或轻薄本,用咕嘟AI在线生图生视频打开网页就能试。
提示词库去哪找,怎么挑才不踩坑
提示词库可以当成别人已经点成功的菜单。你不是去背单词,是去找「这种图别人是怎么跟模型说话的」。库和库侧重点不一样,挑的时候看三件事:有没有真实效果图、标没标适用模型、能不能复制原文。
| 库 | 规模(截至资料记录) | 特点 | 更适合 |
|---|---|---|---|
| 水仙 AI 提示词库 | 约 6601 条中文 | 15 大类 79 细类,每条配图,开源 JSON,支持模糊搜索和一键复制,模板里常留着 {‘{参数}’} 方便替换 | 要中文、要分类细、想自己备份数据 |
| NavXD | 约 7235 条(生图 6394、视频 522、MJ 风格码 313),每日更新 | 中英对照、标作者和适用模型,可按 GPT Image、Midjourney、Kling、Veo、Sora 等筛选 | 既要生图也要视频提示词 |
| imageprompts.co | 5000+ 条 | 声称只收视觉品质过关、社区认可的词,按模型分类 | 想少踩「看起来花哨、实际不出图」的坑 |
水仙的数据和代码在 GitHub 开源,想核对仓库说明可以看水仙提示词库 GitHub 仓库。NavXD 明确不收录点名真人明星、版权角色、露骨内容和以真实品牌为主体的广告,这个原则值得学:你自己存模板时也别往这类内容上靠。
还有一些开源合集,比如按五段式整理的中文 GPT 生图词、带 JSON 索引的案例画廊,适合进阶用户当素材库,不是新手第一站。记住:库本身大多免费复制,真正花钱的是你后面用的生图工具,以各平台规则为准。
从库里复制出来以后,到底怎么用
很多人把整段提示词原封不动丢进另一个模型,然后抱怨「这库不行」。其实提示词像点菜:同一道「红烧肉」,川菜馆和本帮馆做法完全不是一回事。SD 1.5、SDXL、Pony、Flux 听词的习惯差很多,新模型更吃自然语言,老二次元底模更吃标签。
- 先锁定模型。准备生图时到本站图片生成模型列表按用途挑模型,看页面写的底模类型和触发词,再回头挑库里标注了同一类模型的条目。
- 对着效果图只改你在乎的部分:人物换成你的角色,场景换成你的教室或街道,风格词先留着。
- 把关键信息放最前面。模型对开头更上心,像跟人说话,第一句才是重点。
- 一次只改一个变量:今天只换光线,明天只换镜头,否则你永远不知道是哪句害了画面。
- 负面提示单独写清楚「不要什么」,比在正面堆十个 masterpiece 有用。
如果条目里带 {‘{参数}’} 这种占位,那就是让你填发型、年龄、季节,别连括号一起丢进去。LoRA 可以想成调料包,不是整锅汤:文件放到对应文件夹后,提示词里写触发词,并用 <lora:文件名:权重> 这种写法;底模对不上(比如 SDXL 的包丢给 SD 1.5),画面畸形、空白都常见,别怪提示词库。
一套不容易翻车的提示词结构
库是别人的成品菜,结构才是你自己的菜谱。Civitai 的入门写法把词拆成四块:媒介(照片还是插画)、主体(谁、在干什么、穿什么)、整体环境(地点、心情、光线)、再强调真正重要的细节。词序有用,开头权重大;细节必须跟画面有关,无关的形容词越堆越稀释。英文指南可以对照Civitai 提示词基础结构说明。
中文里一套很好记的五段式是:画面主体 → 细节材质 → 构图画幅 → 风格光线 → 画质要求。例如「一位穿亚麻衬衫的女孩靠在火车窗边」是主体,「皮肤有浅雀斑、玻璃上有水雾」是材质,「中景、微俯」是构图,「黄昏侧光、胶片颗粒」是风格。需要加重时用括号权重,很多老手把 1.3 当常用强度,但那不是魔法数字,过猛一样崩。
- Flux、很多在线新模型:写成正常人说话的完整句子,往往比一串逗号标签稳。
- Pony、Illustrious 这类:老老实实跟模型页的 tag 和 trigger words,别拿 MJ 长文去硬套。
- 质量词(masterpiece 之类)点到为止;提示词太长,重点会被后面的废话淹没。
本地想自己管模板,可以怎么做
只想出图、不想装一堆扩展:助澜把环境打好了,适合纯新手。想玩节点和工作流,再上 ComfyUI 下载和安装教程,把常用提示词做成工作流里的固定节点,改一处就能整图换风格。已经习惯 WebUI 界面的老用户可以继续用秋叶整合包,但更新确实慢、插件兼容也烦人,我不会拿它当入门第一推荐。
若你还在用 A1111 类 WebUI,和「模板」最相关的几件事:
- 内置的 Prompts from file:把多条提示词存成 txt,还能带宽度高度这类参数,适合批量试同一主题。
- sd-dynamic-prompts:让模板会「变」,比如 {‘{house|apartment}’} 随机抽场景,通配符目录像一抽屉便签。
- StylePile:用下拉菜单混艺术家、风格、情绪预设,省得每次手打一长串。
- PromptsBrowser 一类扩展:在软件里搜自己的提示词目录,第一次运行会建空文件夹,库要你自己导入。
电脑跑不动、显存报警、安装报错装到怀疑人生的,别死磕本地。咕嘟走在线,不吃你那张卡。本地报错也可以先翻本站常见问题,再决定是继续装还是换路。
常见问题
同一套提示词,换个模型怎么就完全不是一回事?
很正常。老 SD 更吃标签和词序,Flux 等更吃整句描述,Pony 还要特定 tag。先看模型页推荐写法和 trigger words,再从库里筛「适用该模型」的条目,不要拿 Midjourney 长文直接喂给本地 1.5。
提示词越写越长,图反而更糊更乱?
权重被摊薄了。各段长度尽量均衡,关键主体放前面,质量词少而准,负面提示把多余元素挡掉。改的时候一次只动一处,不然你不知道是哪句在捣乱。
库里的图很好看,我复制过去完全不像?
对方用的底模、LoRA、采样步数、种子你都没有。先对模型,再对画幅和风格词,最后才加自己的角色。有示例图的库优先,没图的「万能模板」多半是作文。
没有 N 卡或者笔记本发热严重,还要装提示词扩展吗?
没必要。在线库用浏览器复制就行,生成放到助澜或咕嘟。本地扩展是给已经跑起来的 WebUI 锦上添花,不是入门门票。
先找带效果图、标了模型的库,复制后按「主体—细节—场景—风格」改,关键句放前面;新手用助澜上手,机器不行就用咕嘟,进阶再把模板沉到 ComfyUI 工作流里。有问题欢迎加入本站交流群一起看图改词,别一个人跟报错较劲。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/aist/26472.html



