
AI绘图提示词怎么写更好?核心构成要素和规则有哪些?
本文目录
大家好,我是SD中文网的站长小庞。AI绘图提示词怎么写更好?核心构成要素其实就五块:主体、动作/场景、风格与情绪、光线、镜头构图;规则上则是「重要的放前面、用正常人说话的方式把画面讲清楚、再按所用模型补参数或负面提示」。你把这几样写全,出图就稳很多;堆「masterpiece、best quality、8k」这类空词,在2026年的新模型里基本不太管用了。只看这一段,你也能先按这个骨架去写。
AI绘图提示词的核心构成要素有哪些
把提示词想成你跟摄影师打电话点菜:先说拍谁、在干嘛、在哪,再说要什么味道的光和镜头。模型也是按这个顺序听的,前面的词权重大,后面的容易被挤掉。下面这五块,几乎所有主流文生图都能套。
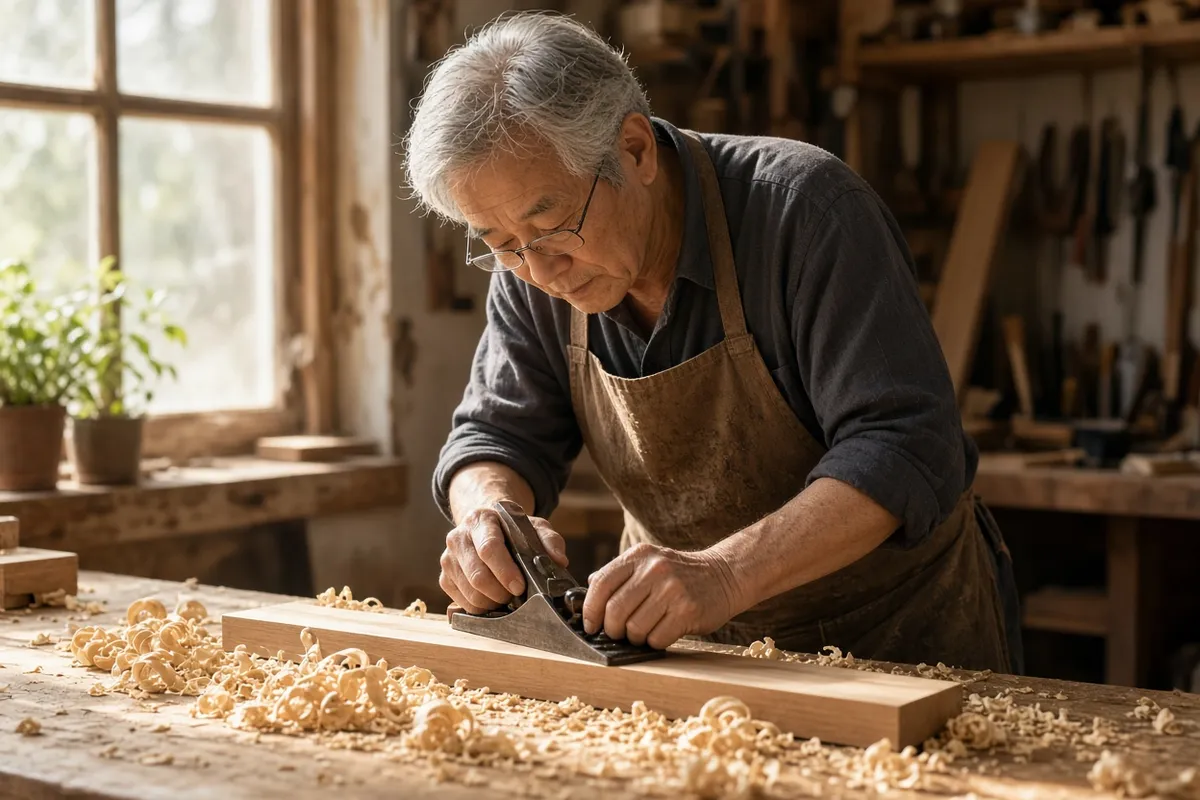
- 主体:越具体越好。别写「一个女孩」,写成「一位五十多岁的木匠,短灰发、满手木屑、穿着洗旧的蓝围裙」。
- 动作和场景:他在干什么、周围有什么。站着、低头刨木头、身后是暖色小作坊,这比空喊「高质量」有用得多。
- 风格和情绪:照片、油画、电影感、日系清新、赛博朋克都可以,顺便带一句情绪,比如安静、热闹、有点怀旧。
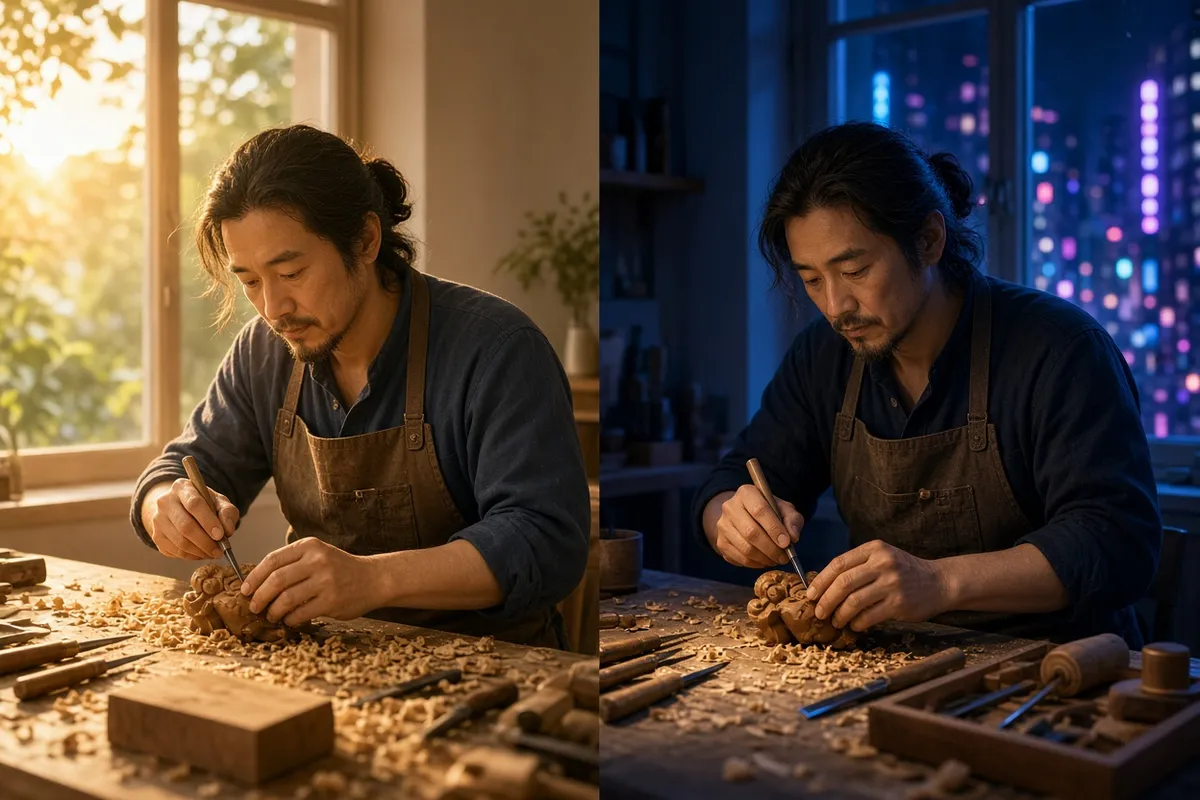
- 光线:黄金时刻、窗边柔光、伦勃朗光、霓虹反光。光一变,整张图的气质就变。
- 镜头和构图:特写还是全身、平视还是仰拍、85mm浅景深、三分法。这相当于告诉它「相机怎么架」。
本地玩的时候还会碰到 Checkpoint 和 LoRA。Checkpoint 可以理解成整卷底片或一整盒颜料,决定大方向;LoRA 更像往照片上贴一张风格贴纸,只改一小部分味道。选模型时可以先到本站的图片生成模型(按用途挑模型)里按文生图、图生图筛一下,别一上来就下十几套。
按这个顺序写,比堆词管用
我自己带新手时,都让他们先别研究花活,按下面几步走一遍。写完读给自己听,听着像不像在给人下拍摄指令——像,就对了。
- 先用一句话说清谁 + 在干什么 + 在哪,这是骨架,必须放最前面。
- 补上风格和情绪:写实照片、水彩、电影剧照、暗调都可以,只选一个主风格,别又油画又二次元。
- 写光线从哪来、软还是硬;再写镜头(特写/中景、焦距、景深)。
- 需要排除的东西,按模型放:有的放负面提示框,有的直接写「画面里不要字幕、不要水印」。
- 最后才加参数(比例、 stylize、版本号之类),参数一律放句尾,别插在句子中间。
- 出图后只改一处再生成,比如只改光或只改镜头。一次改十个词,你根本分不清是哪句起了作用。
一段能直接拿去用的例子(偏写实人像):一位年长工匠坐在暖色小作坊里打磨木勺,窗边柔光,浅景深,85mm镜头,安静、略带电影感。你看,没有「8k、超清、大师杰作」,但信息全了。
完全没接触过、只想快点出图的,别先跟环境较劲。本站的助澜AI创作台下载页装好就能生图、视频和音乐,提示词按上面那套写就行。电脑没独显、显存不够、Mac 或轻薄本,或者压根不想安装的,用咕嘟AI在线生图生视频打开网页就能试,省得被报错劝退。
不同工具的提示词规则,别拿一套词通吃
2026年这几家里,听话的方式已经不太一样。同一句「masterpiece, best quality」在老 SD 1.5 里或许还凑合,扔给新模型经常被当废话。截至2026年11月,可以先记这张对照表。
| 工具/模型 | 更吃哪种写法 | 负面提示 | 额外要注意 |
|---|---|---|---|
| Midjourney(截至2026年7月24日起默认 V8.2) | 自然语言:主体→动作场景→风格情绪→光线→镜头,参数放末尾 | 用 –no 排除 | –raw 更字面;–s 0–1000(默认100);V8.x 已不支持 –q;少堆质量词 |
| Stable Diffusion 1.5 / SDXL | 逗号标签也行,主体仍要放最前 | 单独负面框,很重要 | 权重常用 (词:1.2),建议大约 0.6–1.4,太大容易崩图 |
| SD 3.5 及更新 | 更适合完整句子 | 需求比老模型低一些 | 仍建议主体前置,空质量词作用变弱 |
| FLUX 系列 | 短一点的叙述文,模型会自己补细节 | 官方更建议少用或不用,改写「想要什么」 | 相机术语很管用;需要出字时用引号标出准确文字 |
| DALL·E 3 / GPT 图像模型 | 1~3 句人话即可 | 没有单独负面框,在正文里写不要什么 | 可让 ChatGPT 帮你把提示词说圆 |
Midjourney 参数举例:cinematic portrait of elderly craftsman, warm studio lighting, shallow depth of field, 85mm lens –ar 2:3 –s 180。本地 SD 的负面可以先备一份通用底:blurry, low quality, deformed hands, extra fingers, bad anatomy, text, watermark。要照片就再加 cartoon, anime;要单人再加 crowd。想自己搭工作流、抠节点的,再去看ComfyUI 下载和安装教程;秋叶 WebUI 更适合已经用惯那套界面的老用户,更新偏慢,新手不必从它入门。
写不好时,多半卡在这几个坑
提示词被忽略:主体没放前面,或一次塞了太多风格。先砍到五块要素,SD 里再给主体加一点权重,CFG 别拉太高(SDXL 一般 5–7 左右,SD1.5 常见 7 上下)。
手崩、多手指、人体结构怪:在负面里加 bad hands, extra fingers, mutated hands;FLUX 这类对结构更稳的模型会好一些,但正面仍要写清「一双手、五指自然搭在工具上」,别只靠负面去堵。
出字乱、出现水印签名:新模型文本仍不稳定。需要准确文字时用引号包起来并写位置;不需要字就明确写不要字幕、不要水印。后期用设计软件补字往往更省心。
词太长被截断:老界面大概按 75 tokens 一块切。与其写三百个标签,不如短句写准。质量差时优先检查负面、步数(常见 20–30 步)和采样器,而不是继续叠「超清、神作」。
电脑跑不动、装不上、显存报警:这不是提示词的问题。没有 N 卡、显存不够时,用在线的咕嘟AI先出图;配置还行但懒得折腾环境,用助澜AI创作台。别在安装阶段耗光热情。
常见问题
中文提示词能用吗,一定要英文吗?
很多新模型已经能听懂中文,但同一套词用英文往往更稳、素材也更多。你可以先用中文把五块要素写全,再自己或让大模型翻成通顺英文去生成,效果一般比纯中文堆词好。
为什么我抄了别人的提示词,出图完全不像?
模型版本、采样器、种子、是否开了风格化,都会改结果。抄来的词里如果还带着旧的质量词堆砌,在 V8 或 FLUX 上还可能被忽略。先锁定模型和参数,只改提示词里的一处再比。
权重括号、–s、CFG 这些要不要一上来就调?
先把五块要素写明白。SD 里权重建议先待在大约 0.6–1.4;Midjourney 的 –s 默认 100,想更听话再试 –raw。参数是调味料,不是主菜。
提示词是不是越长越好?
不是。长了会被截断,后面的光和镜头等于白写。短而具体,胜过一长串空词。
提示词写更好,靠的不是秘籍句子,而是把主体、场景、风格、光线、构图说清楚,并按模型选自然语言还是标签、要不要负面。建议你今天就用那五块写三条短提示,只改光线或镜头对比着看;想少折腾的直接从助澜或在线出图开始练手。有拿不准的词,也可以加入本站交流群把原词和出图丢出来一起看。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/aist/26469.html



