
stablediffusion的lora模型是什么意思(如何使用lora)
本文目录
大家好,我是SD中文网的站长小庞。Stable Diffusion 的 LoRA,简单说就是一种“小配件模型”,可以在不更换整个大模型的情况下,给图片增加特定人物、画风、服装或物体效果。使用 LoRA 不需要自己训练模型,下载与当前基础模型匹配的 LoRA,放到正确文件夹并调好权重,就能开始生图。
Stable Diffusion 的 LoRA 模型是什么意思
LoRA 的英文是 Low-Rank Adaptation,中文通常叫“低秩适应”。它最早用于降低大模型微调的成本,后来被应用到 Stable Diffusion 图片模型中。训练 LoRA 时,不需要把整个 Checkpoint(基础模型,可以理解成负责“画画能力”的大脑)重新训练,而是只保存一小部分变化参数,所以文件通常比完整模型小很多,使用起来也更灵活。
在 Stable Diffusion 里,LoRA 更像是给基础模型安装的一个“风格插件”。Checkpoint 决定画面的基本能力,例如写实、二次元、产品图或国风;LoRA 则在这个基础上补充某种角色特征、画风、姿势、服装、材质或概念。它本身一般不能单独生成图片,必须配合对应的基础模型使用。
原文中“Stable Diffusion 模型是使用 LoRA 改进的”这个说法不准确。Stable Diffusion 是基础生成模型,LoRA 是后来用于微调和扩展基础模型的一种方法,并不是所有 Stable Diffusion 都内置了 LoRA。想查看不同基础模型和 LoRA,可以先浏览本站的AI模型库。
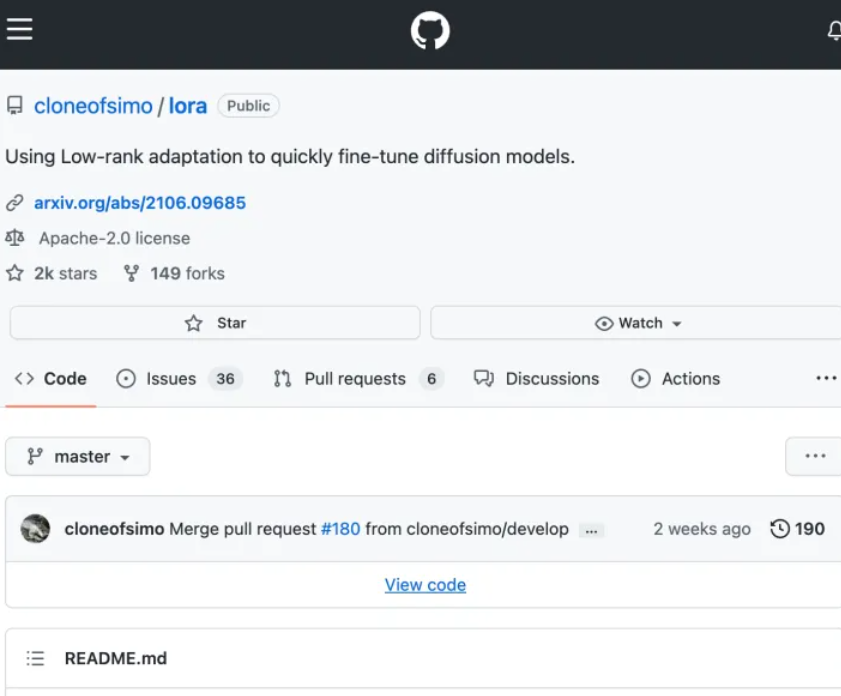
LoRA 常见的用途包括以下几类:
- 人物或角色:让画面更接近某个虚构角色、人物设定或角色服装。
- 画面风格:加入插画、摄影、像素、油画或特定视觉风格。
- 物体和服饰:生成某种鞋子、发型、制服、饰品或产品外观。
- 动作和构图:辅助表现特定姿势、手势、镜头或画面结构。
它不一定会让所有图片都“更逼真”,效果取决于 LoRA 的训练质量、基础模型、提示词和权重。LoRA 的主要价值是让模型更容易获得某种可重复的效果,而不是单纯提升图片清晰度。
使用 LoRA 前,先选对基础模型
LoRA 最容易出问题的地方,不是安装,而是版本不匹配。下载页面通常会标注 Base Model,也就是它训练时使用的基础模型家族。SD 1.5 的 LoRA 通常配 SD 1.5 使用,SDXL 的 LoRA 配 SDXL 使用,不能只看文件名觉得“差不多”就混用。Pony、Illustrious 等也属于有自己特征的模型体系,下载前要认真看说明。
| 你看到的标注 | 通常搭配 | 使用提醒 |
|---|---|---|
| SD 1.5 | SD 1.5 Checkpoint | 不要直接搭配 SDXL 使用 |
| SDXL | SDXL 基础模型 | 显存和模型文件通常比 SD 1.5 要求更高 |
| Pony、Illustrious | 对应的 Pony 或 Illustrious 模型 | 按模型页面的提示词和触发词使用 |
| Flux 等新架构 | 对应的新架构工作流或软件 | 不能按传统 SD 1.5 的方法强行套用 |
最稳妥的做法是先看 LoRA 页面写的基础模型、推荐权重和 Trigger Word(触发词)。触发词就像“暗号”,有些 LoRA 不写它也能有一点效果,但人物、风格类 LoRA 往往需要把作者指定的词放进提示词中。固定同一个随机种子,只修改 LoRA 权重,更容易判断它到底有没有生效。
在 Stable Diffusion WebUI 中如何使用 LoRA
如果你已经习惯网页界面和插件,可以使用本站整理的秋叶 Stable Diffusion WebUI 整合包。当前本站提供的整合包版本是 v4.11,适合 Windows 英伟达独立显卡用户;原版 WebUI 最后一个正式版本为 2025 年 2 月的 v1.10.1,后续基本处于维护状态,所以较新的模型不一定适合用它。
- 下载与当前基础模型匹配的 LoRA,优先选择正规来源提供的 .safetensors 文件,并阅读作者的使用许可。
- 把 LoRA 文件放入 WebUI 的 stable-diffusion-webui/models/Lora 文件夹。文件名尽量使用英文、数字和下划线,避免改成难以辨认的名称。
- 启动 WebUI,在生成按钮附近打开 Extra Networks,也就是模型卡片面板,进入 LoRA 标签并点击刷新。
- 点击对应 LoRA 卡片,WebUI 会把类似 <lora:文件名:1> 的调用内容插入提示词。
- 按照模型页面要求补充触发词,先用一个简单提示词测试,再逐步增加人物、背景和光线描述。
- 先从 0.6 到 0.8 左右的权重试起;如果效果太弱再慢慢增加,出现画面变脏、姿势异常或风格过重,就降低权重。
例如,提示词中可能出现 <lora:my_style:0.7>。这里的 my_style 是文件名,不包括扩展名,0.7 是权重。不同 LoRA 推荐值不一样,作者说明优先级最高。一次测试最好只加载一个 LoRA,等它能正常工作后,再尝试叠加第二个。
ComfyUI 怎么加载 LoRA,出错时怎么办
想使用新模型、搭建工作流,或者不想依赖网页卡片界面的进阶用户,可以选择ComfyUI 下载和安装教程。在 ComfyUI 中,LoRA 通常通过 Load LoRA 节点加载:把 LoRA 文件放进 ComfyUI 的 models/loras 文件夹,刷新界面,在节点里选择它,再分别调整模型权重和文本编码器权重,最后接回采样流程。
ComfyUI 的节点可以理解成一条流水线:基础模型负责提供画画能力,LoRA 节点负责加上某种效果,采样器负责把噪声一步步变成图片。节点接错、模型选错,结果就可能不对。新手不用一开始研究所有参数,先找一个能正常运行的基础工作流,再替换 LoRA。
- 列表里看不到 LoRA:检查文件夹是否为 models/Lora 或 models/loras,确认文件已经下载完整,然后刷新页面或重启软件。
- 加载后没有效果:优先检查基础模型是否匹配,再检查触发词、文件名和权重。
- 效果太重或画面变形:降低权重,一次只测试一个 LoRA,并固定随机种子。
- 多个 LoRA 互相干扰:先分别测试,再降低各自权重;人物、画风和服装 LoRA 叠加时尤其容易冲突。
- 电脑运行很慢或装不上:本站 WebUI 整合包需要 Windows 和英伟达独立显卡,最低能用显存为 4GB,推荐 8GB 以上。没有 N 卡、使用 Mac 或轻薄本,可以试试咕嘟AI在线生图生视频,不用安装和本地显卡。
如果你只是第一次接触 AI 创作,不想先处理模型路径、显存和节点,建议从助澜AI创作台开始,它把运行环境和基础操作准备好了。想深入研究 LoRA、工作流和节点,再转到 ComfyUI 会轻松一些。
常见问题
LoRA 是不是一个完整的大模型?
不是。LoRA 通常是附加模型,需要和匹配的 Checkpoint 一起使用,单独放进软件里不能正常生成完整图片。
使用 LoRA 前必须自己训练吗?
不需要。普通使用者只要下载别人训练好的 LoRA,放到正确目录并加载即可;只有想训练自己的角色或风格时,才需要准备图片和训练工具。
为什么加载了 LoRA,图片看起来没有变化?
最常见原因是基础模型不匹配、缺少触发词、权重太低或文件没有放在正确目录。建议固定随机种子,换成简单提示词逐项排查。
LoRA 权重越高越好吗?
不是。权重太低可能不明显,太高则容易出现过度风格化、细节异常或画面变形。通常从作者推荐值或 0.6 到 0.8 左右开始测试,再按效果微调。
总结一下,LoRA 就是附加在基础模型上的“小插件”,关键是匹配模型家族、放对目录、补充触发词并控制权重。新手建议先用助澜AI创作台少折腾环境;已经在用 WebUI 的用户按上面步骤操作,想掌握最新模型和复杂工作流则优先学习 ComfyUI。还有问题可以加入本站交流群继续交流。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/sd/sd-model/149.html



