
如何云端部署stablediffusion(stablediffusion可以在GPU服务器上跑吗)
本文目录
大家好,我是SD中文网的站长小庞。可以,Stable Diffusion 完全能在 GPU 服务器上跑,云端部署也是本地显卡不够时很常见的办法。你租一台带英伟达显卡的云主机,把界面装上,用浏览器远程出图就行。不过如果你只是想尽快生成图片或视频,不一定非要自己搭云端,先看清自己属于哪一类,能少走很多弯路。
什么人适合上云,什么人其实不用折腾
云端听着高级,拆开就是:租一台带显卡的电脑,把模型和软件放上去,打开网页生成。显卡的显存可以想成书桌上的空位,模型越大、图越大,桌子就要越宽,不够就会报内存错误、直接崩掉。
完全没接触过、只想尽快出作品的新手,我更建议先用本站的助澜AI创作台下载和介绍。它把模型和运行环境都打好了,打开就能做图片、视频和音乐,不用自己装驱动、配 CUDA。电脑没有英伟达独显、显存不够、用的是 Mac 或轻薄本,或者压根不想安装,可以直接用咕嘟AI在线生图生视频,打开网页就能用。
想自己搭流程、追新模型的,优先看ComfyUI 下载和安装教程。节点就像搭积木,新模型通常在这里支持得最快。已经习惯网页滑条和插件的老用户,本地 Windows 可以继续用秋叶 WebUI 一键整合包;但要诚实说一句:WebUI 原版最后一个正式版是 2025 年 2 月的 v1.10.1,之后基本停更,Flux、Qwen-Image 这类较新的模型,一般还是得去 ComfyUI。
真正适合云端部署的,通常是这几种情况:家里没有能用的英伟达显卡;想跑更大的模型,24GB 显存本地买不起;需要把服务挂在网上给自己或小团队用。如果只是偶尔玩两张图,上云又要学 Linux、又要盯着计费,性价比并不高。
GPU 服务器上跑得动吗,显存怎么选
能跑,而且应该用 GPU 跑。CPU 也能硬算,但会慢到让人怀疑人生。云端务必选英伟达 GPU,并确认驱动和 CUDA 能被 PyTorch 认出,否则你看着租了显卡,实际可能在用 CPU,利用率一直是 0。
截至 2026 年 11 月,单张图、默认分辨率、做过半精度和卸载优化时,显存可以按下面这张表来估。具体还跟分辨率、批量、ControlNet、多 LoRA 有关,表里是大概范围,下单前以你用的平台说明为准。
| 模型 | 大概显存 | 内存建议 | 备注 |
|---|---|---|---|
| Stable Diffusion 1.5 | FP16 大约 3–4GB,4GB 卡也能试 | 8GB 起,16GB 更舒服 | 老模型,云上也能跑,但不是现在的主力 |
| SDXL | FP16 大约 8GB,建议 12GB 以上 | 16GB 以上 | 加 LoRA、ControlNet、Refiner 还会再涨 2–4GB |
| SD 3.5 Medium | FP16 大约 12GB,FP8 大约 6GB | 16GB 以上 | 量化后消费级卡也能试 |
| SD 3.5 Large 及更高分辨率、批量出图 | 建议 16–24GB | 32GB 更稳 | 云上常见是 24GB 这一档 |
早期官方仓库曾写过大约 10GB 显存起步,后来有了半精度、注意力优化、模型卸载和量化,门槛低了不少。SD 3.5 系列可以从 Stable Diffusion 3.5 官方介绍核对许可和说明:社区许可一般允许非商业使用,以及年收入低于 100 万美元的商业使用,更大的商业用途要走企业许可,以官网为准。
个人租 GPU 时,24GB 这一档通常最好用。系统内存别只看显存:SDXL 建议 16GB 以上,更大的模型建议 32GB 以上。硬盘用固态,模型建议放到可持久保存的磁盘里,不然实例一销毁,几十个 G 的模型得重新下。
云端部署可以按这几步做
云厂商很多,大厂虚拟机能用,个人更常见的是按小时租 GPU 实例。下面按 Linux(一般是 Ubuntu)来说。秋叶整合包是打给 Windows 本地用的,不要指望把它原样丢到 Linux 云主机里双击启动。
- 开通一台带英伟达 GPU 的云主机,系统选 Ubuntu,显存按上表留余量。同时确认计费是按时还是包月,用完一定要关机或销毁,否者费用会一直跑。
- 安装官方 NVIDIA 驱动,进系统后确认能识别到 GPU。驱动、CUDA 和 PyTorch 版本要匹配,不匹配时最典型的现象就是“租了卡却跑在 CPU 上”。
- 安装 Git,以及 Python 3.10 或 3.11。云端不需要你在网页上找一个所谓的“官方安装程序”点下一步,现在主流都是克隆项目、自动建虚拟环境。
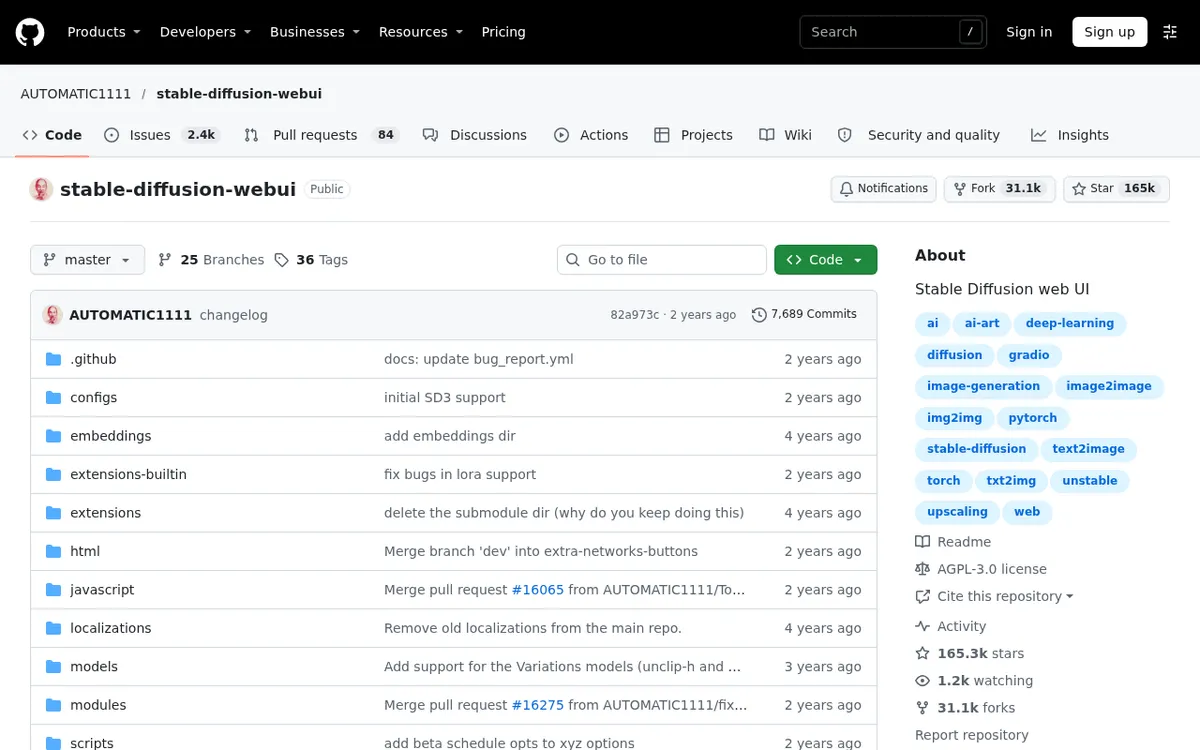
- 若你已经熟悉 WebUI 界面,可克隆 AUTOMATIC1111 的 WebUI 项目主页,在目录里执行启动脚本 webui.sh,它会自己建环境并拉依赖。想追新模型、自己搭流程,直接上 ComfyUI 更合适。
- 把 Checkpoint 放到对应模型目录。Checkpoint 就像一整本画册,LoRA 则是贴在上面的贴纸,只改画风或人物,体积小得多。权重优先用 safetensors 格式,模型一般从 Hugging Face 等正规渠道获取,需要同意许可的先在网页上同意再下载。
- 启动时加上允许远程访问的参数(WebUI 里常见是 listen),用浏览器打开云主机的地址和端口(WebUI 默认常见是 7860)。公网暴露时务必加访问密码,不要把端口裸着挂在网上。
- 第一次启动会下载依赖,等十几分钟甚至更久都正常。模型不要每次跟着实例一起删掉,放到持久盘或网盘卷里,下次开机直接用。
显存紧张时,WebUI 可在启动参数里按需加 medvram 或 lowvram(把暂时不用的模块卸到内存,像桌上东西太多就先收进抽屉),以及 xformers 或 sdp 注意力优化。VAE 出怪纹可以试试 no-half-vae。这些是省显存的常规手段,不是破解,也改变不了“桌子实在太小就摊不开大画”的事实。Forge、ComfyUI 在显存管理上通常比老 WebUI 更省,SD 3.5 这类新架构优先考虑它们。
装好之后就是正常出图:写提示词,选模型和采样步数,点生成。不一定非要先给一张输入图,文生图只靠文字就行;图生图才需要再垫一张参考图。

云上最容易踩的坑
报错别慌,云端和本地其实是同一类问题,只是多了“远程连不上”和“忘了关机还在扣钱”。
- CUDA Out of Memory:最常见。降低分辨率和批量,开 medvram/lowvram,改用半精度或量化,或换成 ComfyUI;实在不够就换 24GB 的卡,别在 8GB 上硬堆 SD 3.5 Large。
- GPU 利用率一直是 0:多半没装对驱动,或 PyTorch 不是 CUDA 版。先在服务器里确认当前环境能访问到 GPU,再启动界面。
- 第一次启动特别慢、依赖下失败:服务器网络要能访问 Git 和 PyPI;国内机器常见是连不上外网,需要按云厂商自己的网络说明处理,不要随便下来路不明的“加速包”。
- 网页打不开、代理超时:检查安全组有没有放行端口,启动参数有没有 listen,日志里有没有真正起来。有的平台网页转发不稳定,可以按它的文档改用 TCP 方式连。
- 模型架构对不上:SD 3.5 需要对应的文本编码器和流水线,老 WebUI 不一定带得动。新模型优先 ComfyUI,别在停更的界面里死磕。
费用上没有“租一次永久免费”这回事,按小时的实例用完就关。模型、密钥、访问密码走官方和本站提供的正规说明,不承诺绝对安全,端口暴露在公网时尤其要小心。
常见问题
没有英伟达显卡的云服务器能跑吗?
能跑,但会非常慢,只适合验证流程,不适合正经出图。AMD、核显、纯 CPU 实例都不是这个任务的好选择。本地也没有 N 卡的话,与其硬装,不如先用咕嘟AI在线生成。
云端部署一定比自己电脑强吗?
不一定。你租到的卡比家里强,速度才会强;租了低显存再开一堆插件,照样爆内存。云端的优势是“按需借一台更好的电脑”,不是自动变高质量。提示词和模型选不对,换再贵的卡也救不回来。
想用 SD 3.5、Flux 这类新模型,WebUI 还行吗?
WebUI 原版已经很少更新,较新的图模和视频模一般要在 ComfyUI 里用。云端如果目标就是新模型,直接部署 ComfyUI,少走一层兼容问题。已经把工作流建在 WebUI 上的老用户,可以继续用,但别指望它能跟上所有新架构。
我是第一次用,要不要先去租 GPU?
不用。先在助澜AI创作台或咕嘟AI上搞清楚提示词和模型怎么选,真有 24 小时出图、要自己挂服务的需求,再考虑云端。很多人一上来就开虚拟机,结果半天耗在环境和账单上,一张图还没出来。
总结一下:Stable Diffusion 可以在 GPU 服务器上跑,云端部署对没独显、要大显存的人很实用;但对纯新手,先把图出出来比先学会租服务器更重要。建议新手先用助澜AI创作台或咕嘟AI上手,进阶再在云上装 ComfyUI;用完实例记得关机。遇到报错可以加入本站交流群,把配置和日志发出来,大家一起看。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/sd/sd-knowledge/241.html



