
ComfyUI的CLIP Text Encode怎么用
本文目录
大家好,我是SD中文网的站长小庞。ComfyUI 里的 CLIP Text Encode,就是把你写的提示词翻译成模型能听懂的条件信号(CONDITIONING),再交给后面的采样器去画图。你只要把有效的 CLIP 接进这个节点、把正面或负面词填进文本框,输出接到 KSampler 的 positive 或 negative,提示词才会真正起作用。它是软件自带的核心节点,不用单独下载,搜索 CLIP Text Encode 就能加出来。
第一次碰节点就头晕的朋友,别硬扛:想打开就出图、出视频,更适合先用本站的助澜AI创作台免费下载和上手说明。已经决定玩工作流的,再往下看这个节点怎么用。
这个节点到底在干什么
你可以把它想成餐厅里的传菜员。你在菜单上写「红烧排骨少油」,厨师看不懂你的口语,得有人把这句话翻译成后厨工单。CLIP 模型就是那个翻译官,CLIP Text Encode 就是把工单交出去的窗口。Checkpoint 更像整套厨房(炉子、调料、说明书捆在一起),里面通常已经带着一份 CLIP;你从加载器把 CLIP 线拉过来,这个节点才有东西可翻译。
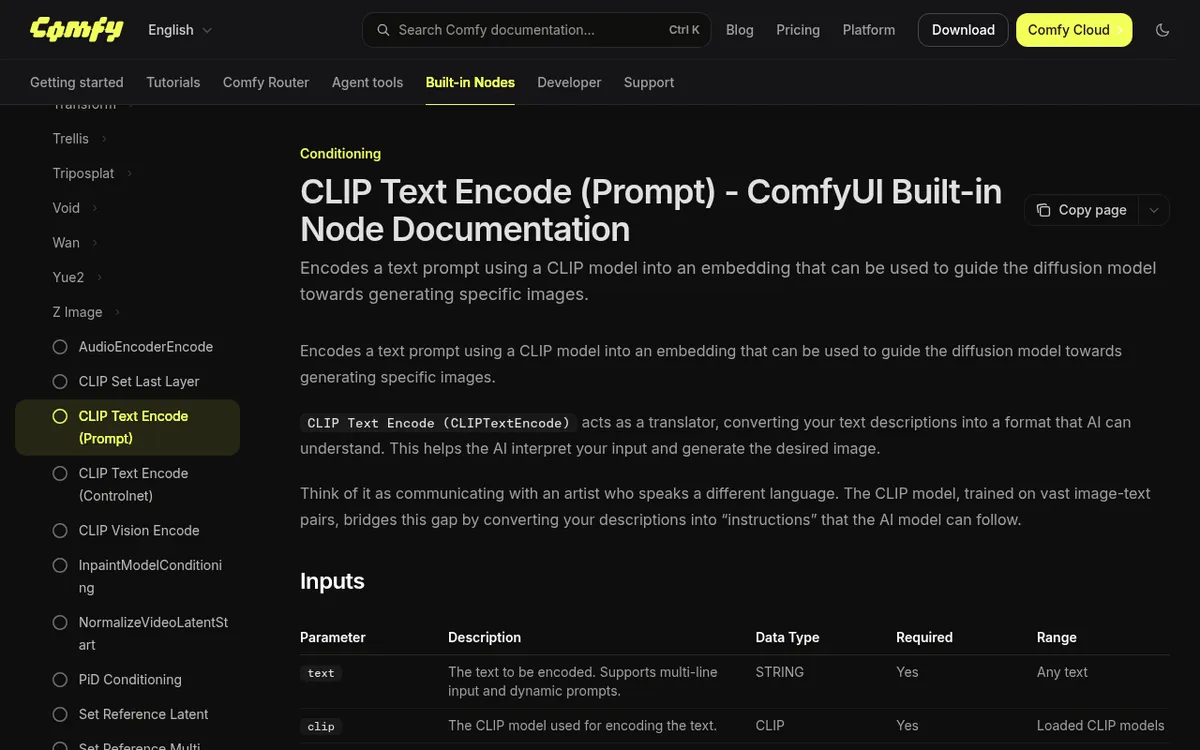
官方也是这个意思:它把人类文本变成 AI 能理解的嵌入,输出 CONDITIONING,专门给采样器当正面或负面条件。文本支持多行,也支持动态提示词。CLIP 没接上、或者 checkpoint 里根本没有可用的文本编码器时,节点会直接报错,不是“还能凑合跑”,是跑不起来。
输出那根线看起来抽象,其实就一件事:告诉采样器“朝哪个方向画”和“别往哪个方向画”。所以同一个工作流里,你几乎总会放两个 CLIP Text Encode,一个写想要的,一个写不想要的。
怎么接到工作流里
这个节点不用装插件。在画布上双击或右键,搜 CLIP Text Encode 或 CLIPTextEncode 就能找到。下面这几步是最常见的接法,适合 SD1.5 这类把 CLIP 打在 checkpoint 里的模型。
- 先放一个 Checkpoint 加载器,加载你的大模型。从它的 CLIP 输出口拉线,接到 CLIP Text Encode 的 clip 口。这一步漏了,后面必报错。
- 在节点的 text 框里写提示词。想要的内容写一份,不想要的再复制一个节点写一份。可以换行,句子或标签都行。
- 把正面那个节点的 CONDITIONING 接到 KSampler 的 positive,负面接到 negative。再接上模型、空潜空间和 VAE,点运行就能出图。
- 换模型时,优先确认 CLIP 还在不在这条线上。有的新模型 checkpoint 里不含文本编码器,就要改用专门的 CLIP / DualCLIP 加载器,别死盯着普通 Checkpoint 加载器。
想自己搭流程、第一时间跟新模型,用ComfyUI 官方桌面版的下载和安装说明即可。截至 2026 年 11 月,本站网盘提供的桌面版正式版是 v1.1.9,装好后会自动更新;桌面版里每套安装还可以单独把 ComfyUI 更新到 v0.45.0 一带。CLIP Text Encode 没有独立版本号,跟着主程序走。
提示词怎么写才听得懂
框里可以随便打字,但模型不是按你的文学水平打分,是按它学过的图文对来理解。写清楚主体、场景、风格,比堆一长串空话有用。权重、Embedding、正负分开,是这个节点上最常改的三件事。
- 加重或减轻某个词:用 (word:1.2) 提高权重,数字小于 1 就减弱。也可以写 (word) 或 [word] 做简单加强、减弱。别把整段都加到 1.5 以上,容易画面发僵。
- 调用 Embedding:把 .safetensors / .pt / .bin 放到 ComfyUI 的 models/embeddings 文件夹,提示词里写 embedding:文件名,扩展名常常可以省略,比如 embedding:EasyNegative。它像一块预制调料包,不是新模型,是往提示词里塞一小段学好的向量。
- 正负各写各的:正面写你要的主体和画风,负面写糊、残缺、多余手指这类通病。两个节点共用同一根 CLIP 线,文本内容分开。
- 多行没问题:官方支持多行输入。一条一个意思,自己回头改的时候也轻松。
选大模型时,提示词习惯要跟着模型走。SD1.5 一类更吃标签风,新一点的模型更吃完整句子。可以先到本站按用途挑图片生成模型,选定后再决定提示词写成词还是写成话。
不同模型该用哪个编码节点
基础的 CLIP Text Encode 主要伺候单 CLIP 编码器,典型就是 Stable Diffusion 1.5 模型介绍和适用场景 这类。SDXL、SD3、Flux 后来都有专用编码节点,不是你手贱多点了一步,是编码器数量和分词方式本来就不一样。拿旧节点硬套新模型,轻则权重失灵,重则 CLIP 是空的直接报错。
| 节点 | 更适合谁 | 你要记住的一点 |
|---|---|---|
| CLIP Text Encode | SD1.5 等单 CLIP 模型 | 一个文本框,一根 CLIP 线,最常见的入门接法 |
| CLIP Text Encode (SDXL) | SDXL | 双编码器,提示词往往要按 g / l 两路来理解 |
| CLIP Text Encode SD3 一类 | SD3 / SD3.5 | 文本编码器常需单独加载,别只靠普通 Checkpoint |
| CLIP Text Encode Flux 一类 | Flux | T5 侧更吃完整句子,CLIP-L 侧更吃短标签,别把老式权重语法整段复制过去 |
Flux 专用节点里还有 guidance 一类参数,默认常见是 3.5,社区里很多人会往 1.8~2.5 调,但没有放之四海都对的数,以你当前工作流和模型为准。T5 那一路适合把话说完整,CLIP-L 那一路适合关键词。想核对节点定义,可以看 ComfyUI 官方的 CLIP Text Encode 中文说明。
报错了先查这几处
新手在这个节点上栽跟头,十有八九不是提示词写得不够文艺,是 CLIP 没接上,或模型根本没带文本编码器。
- clip input is invalid: None,或提示 checkpoint 不含有效 CLIP / text encoder:先看线上有没有断。Flux、SD3.5 这类要单独下 clip_l、clip_g、t5xxl 等编码器,放到 models/clip 或 text_encoders,用 DualCLIPLoader 或对应加载器接进来。只丢一个 checkpoint 进去,这个节点会罢工。相关讨论可对照 ComfyUI 关于 CLIP 无效的 issue。
- 显存爆了、CUDA 报错:编码节点本身不胖,但 T5XXL 这类大家伙在 FP16 下也要吃掉数 GB 显存。可尝试 –disable-cuda-malloc、更新驱动、换匹配的 PyTorch,或拿掉打架的自定义节点。电脑没有独显、显存不够、轻薄本或只想网页里出图,直接用咕嘟AI 在线生图生视频,不用装环境。
- 权重怎么调都不对劲:先确认你用的是不是该模型的专用编码节点。新编码器上盲目套 (word:1.8) 这种老语法,经常不如把句子写明白。
模型文件走官方或本站正规渠道,不承诺永久免费、也别下来路不明的整合包。桌面版装好后会自己检查更新,网盘包不是当天最新也没关系。
常见问题
一定要两个 CLIP Text Encode 吗?
出图时几乎都要。一个接 positive 写想要的,一个接 negative 写不要的,两根 CONDITIONING 都进采样器。只接正面也能跑,但画面脏点、多余物体会明显变多。
提示词里的中文能用吗?
能不能听懂取决于你加载的 CLIP / 文本编码器,不取决于这个节点的框。有的模型中文很弱,写成英文标签更稳;有的新模型更吃自然句子。先小段试,别一上来贴八百字。
Embedding 写了名字没效果?
检查文件是不是放在 models/embeddings,提示词是不是 embedding:文件名,以及当前 CLIP 能不能吃这种向量。名字抄错、放错文件夹,节点不会单独弹“找不到这块调料”的友好提示,只会当普通单词忽略掉。
我只想出张图,有必要学这个节点吗?
没必要从节点起步。完全没接触过、怕安装和报错的,用助澜AI创作台更省事;电脑跑不动本地的,用咕嘟AI打开网页就能生成。只有你已经在 ComfyUI 里连线了,才需要把这个翻译窗口接对。
记住三件事:CLIP 线必须是有效的,正负提示词分开写,新模型优先用它自己的编码节点。建议你今天就拿 SD1.5 的默认工作流改两个文本框试一遍,看懂 CONDITIONING 往哪插;节点实在别扭就先去助澜里出图,等手熟了再回 ComfyUI。有卡壳的,欢迎加入本站交流群把工作流截图丢出来一起看。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/sd/26234.html



