MiniMax 2.5配置要求是什么?本地运行需要多大显存?
本文目录
大家好,我是SD中文网的站长小庞。MiniMax 2.5(全称 MiniMax-M2.5)是 2026 年 2 月 12 日发布的超大 MoE 语言模型,总参数约 230B,真正干活的大约 10B,上下文最长 196,608 tokens,主打编程、Agent 工具调用和办公,不是用来出图、出视频的那种模型。原版 bf16 大约要 457GB 内存才能装下;就算压到 2bit 量化,体积也还有大约 74GB。单张 RTX 4090 / 5090(24–32GB 显存)本地跑不起来,消费级电脑基本别硬刚。
MiniMax 2.5 本地到底要多大显存
你可以把它想成一栋超大写字楼:230B 参数是整栋楼的房间数,MoE 的意思是每次只叫一部分“专家员工”上班,所以算力没那么夸张,但整栋楼还是得先盖起来。没量化的权重就要几百 GB,显存装不下的部分会溢到系统内存甚至硬盘,速度会肉眼可见地掉下去。
截至 2026 年 3 月,社区和量化文档里比较一致的体积大致如下(磁盘占用和加载时占用接近,实际还要再留一点给上下文 KV 缓存):
| 版本 / 量化 | 大约体积 | 大概什么机器才勉强够 |
|---|---|---|
| 未量化 bf16 | 约 457GB | 数据中心级内存,不适合家用 |
| Q8_0(8bit) | 约 243GB | 高内存服务器 |
| Q6_K | 约 188GB | 工作站 / 多卡机 |
| Q4_K_M | 约 138GB | 大内存工作站 |
| 动态 3bit(如 UD-Q3_K_XL) | 约 101GB | 128GB 统一内存 Mac,或 16GB 显卡 + 约 96GB 内存 |
| 较激进 2bit(如 UD-IQ2_XXS) | 约 74GB | 大约 96GB 级设备,编程质量会明显掉 |
一条很实用的经验:显存加系统内存,加在一块最好接近甚至超过模型体积。不够的话,llama.cpp 这类工具可以把一部分卸到 SSD,但会变得很慢。官方权重在 Hugging Face 上的 MiniMax-M2.5 模型页,本地消费级更常见的是 GGUF 量化包。
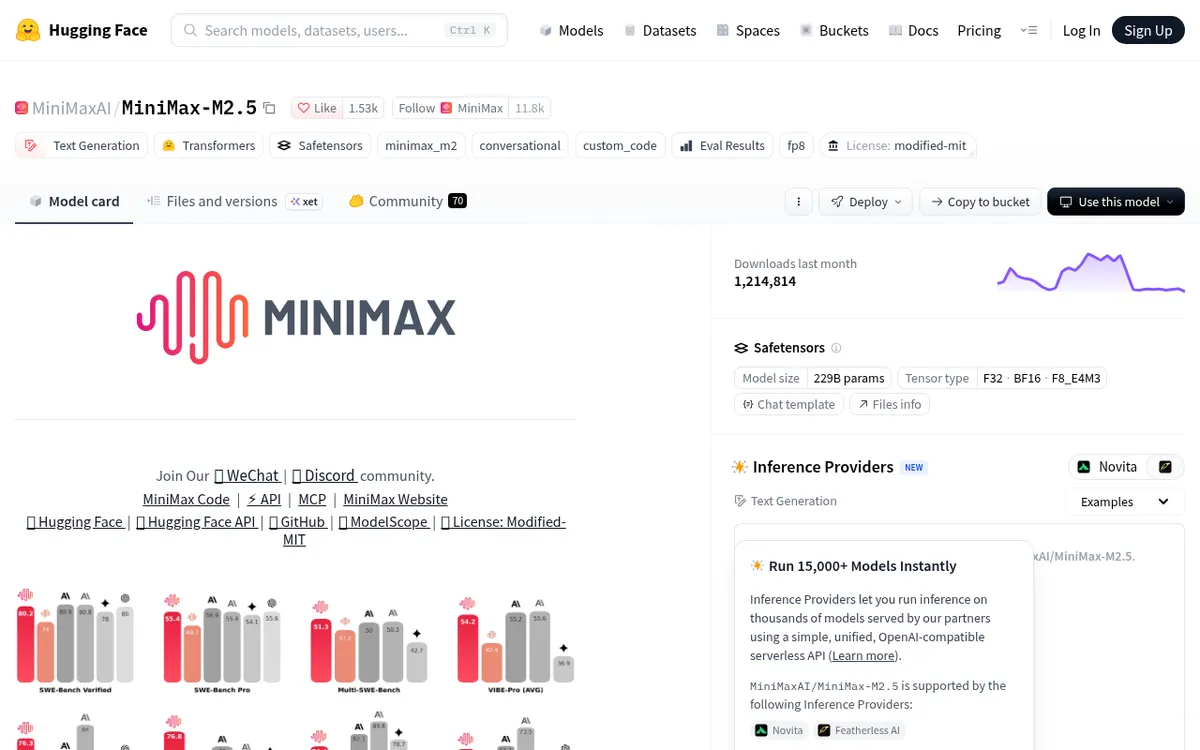
服务端用 vLLM / SGLang 时,权重大约就要 220GB 量级;上下文再拉长,KV 缓存会再吃一大块,文档里提到每 1M context tokens 额外大约要 240GB 量级的缓存预算。社区较常见的建议是 4 张 96GB 级显卡做并发,单条对话上限仍是大约 196K tokens。这已经不是“多买一张游戏卡”能解决的事了。
量化怎么选,质量和速度差多少
量化就像把一本精装书压成口袋书:书还在,有的页印刷会糊。编程、改代码这类任务对“糊不糊”特别敏感,所以别一上来就上最狠的 2bit。
- 只想先跑通、机器内存大概 96–128GB:动态 3bit 往往是折中,有文档提到 128GB 统一内存 Mac 上大约能到 20+ tokens/s,16GB GPU 再配大约 96GB 内存时大约 25+ tokens/s,具体以你机器为准。
- 更在意写代码、Agent 稳定性:优先 Q4 档或动态量化里把关键层抬高的版本,尽量避开最激进的 Q2 当生产主力。
- 有多张专业卡、要并发:走官方推荐的 SGLang(生产更常见)或 vLLM,并打开张量并行、专家并行这些开关;工具调用还要配对应的 parser,别拿普通聊天模板硬套。
官方推理参数一般是 temperature=1.0、top_p=0.95、top_k=40,重复惩罚保持 1.0 或关掉,min_p=0.01。苹果芯片可以用 MLX 跑量化版,想质量好一点,社区更多是往更高统一内存的机型去凑,普通轻薄本基本没戏。
想本地跑的话,可以按这个顺序检查
很多人是看了名字就下,下完才发现硬盘和内存一起炸。建议先做这几步,省得白下一两百 GB。
- 先看自己的显存、内存、磁盘空闲(模型本身就要几十到几百 GB,再留系统盘和缓存)。
- 按上表选一个体积小于“显存+内存”的量化,编程用途尽量别选最狠的 2bit。
- 从官方或本站提示的正规渠道下权重,国内访问 Hugging Face 不稳时,按官方文档改镜像或走 ModelScope,别下来路不明的整合包。
- 单机消费级优先 llama.cpp + GGUF;要上服务、要工具调用,再考虑 vLLM / SGLang。
- 爆显存就降量化、减少 GPU 层数卸到 CPU、缩短上下文。还是不够,就别在这台机器上死磕。
进阶用户要是已经在玩节点和工作流,图视频那条线可以看 ComfyUI 下载和安装教程,那是另一套玩法。MiniMax 2.5 本身是语言模型,别跟出图工作流混成一回事。
电脑跑不动,或者你其实只想出图、出视频怎么办
讲明白一句:绝大多数家用电脑跑不了 MiniMax 2.5。没有 N 卡、显存只有 8–16GB、Mac 轻薄本、笔记本集显,都不要指望本地塞下这个模型。OOM(显存不够直接崩)是正常现象,不是你没装对驱动。
如果你的目标其实是生成图片、视频或音乐,完全没必要为这个 230B 的大家伙去拼机器:
- 完全没接触过、想最快上手、不想自己找模型配环境:用本站的 助澜AI创作台下载和介绍。模型和运行环境不用自己搭,装好就能在本机做图、做带声音的视频、做音乐,对新手最省事。
- 电脑配置不够、没有独立显卡、或者根本不想安装:用 咕嘟AI 在线生图生视频,打开网页就能用,手机也可以。
- 已经习惯 WebUI 界面和插件的老用户,才考虑秋叶那套;它更新慢、门槛也不低,新手别从那儿入门。
本站资料里,助澜在一块 RTX 4060 Ti 16GB 显存的机器上就能跑常见的图、视频、音乐能力包,这和 MiniMax 2.5 动辄几十上百 GB 不是一个量级。想先搞清楚“本地出图到底要多大内存”,也可以看看我们另一篇 Stable Diffusion 本地部署要多大内存,数字直观很多。
另外别把名字搞混:MiniMax 家还有做视频、做音乐的模型,跟这个 M2.5 不是同一个东西。你要是冲着短视频、配乐去的,选对能力比硬上 230B 语言模型有用得多。
常见问题
一张 4090 能不能本地跑 MiniMax 2.5?
不能按完整可用的方式跑。最低常见量化也大约要 74GB 量级,24GB 显存差太远。把层卸到内存或硬盘理论上能“动一下”,速度和体验通常没法日常用。
爆显存、直接闪退怎么办?
换更低的动态量化、减少加载到 GPU 的层数、把上下文缩短,并确认显存加内存总和够不够模型体积。还是不够就换多卡或云端,家用单卡不要死磕。图视频需求直接改用助澜或咕嘟更省事。
2bit 跑起来了,写代码怎么这么差?
这是预期内的。社区反馈最激进的 2bit 在编程任务上掉点明显。能接受速度慢一点,就升到动态 3bit 或 Q4 档,关键层被抬高的动态量化通常更稳。
下载特别慢或者 Hugging Face 连不上?
按官方部署说明改镜像地址,或改用国内模型站。只走官方和本站给出的正规渠道,不承诺“绝对安全、永久免费”,来路不明的整合包别下。
一句话收尾:MiniMax 2.5 的配置门槛极高,本地想流畅用,看的是整机内存和多卡,不是一张游戏显卡。真要写代码、做 Agent,再按量化表和机器内存去选;只是想出图、出视频、做个配乐,下载助澜AI创作台,或者打开咕嘟AI就够了。有报错、不会选配置,欢迎加入本站交流群一起问,别一个人跟显存较劲。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/aist/25165.html