
AI反推视频提示词教程:视频怎么反推提示词?
本文目录
大家好,我是SD中文网的站长小庞。视频怎么反推提示词?就是把一段现成片子交给能看视频的 AI 或专用反推工具,让它按镜头把主体、运镜、动作、光影和节奏写清楚,再整理成可灵、即梦、Sora 这类模型能吃的提示词。截至 2026 年 11 月,靠谱做法是「多模态大模型直接看片」加上「把运动设计当一等公民的反推 Skill」,而不是只写画面里站着谁、背景是什么。一次反推没法 100% 复刻原片,把它当可改的底稿,生成后再对照原片改运镜和负向词,才是正经流程。
先搞清楚:反推的不是海报,是「它怎么动」
很多人把视频丢进聊天框,只得到「一个女孩在街上走,阳光很好」这种静帧描写。拿去生成,脸会飘、镜头乱晃、动作像融化,这很正常。视频模型真正吃的是时间轴:镜头怎么推、主体怎么走、物理连不连续。你可以把它理解成:文生图提示词像给一张海报写文案,视频反推则是给导演写分镜——分镜不写清楚,演员再好看也演不顺。
社区里专门做这件事的开源 Skill,会强调运镜、时序、主体运动和物理连续感,并在忠实还原之外叠一层电影感(风格、导演预设、一致性锚点)。它也提醒过:多数开源反推只描述画面里有什么,对「怎么动」几乎沉默。所以你选工具时,优先看它会不会逐镜写景别、运镜、时长和动作,而不是只会出一段漂亮形容词。
- 片子尽量短:理想是十几秒以内,超过 15 秒一般要拆任务,国内不少平台单次时长也有上限。
- 格式常见是 MP4、MOV;具体体积限制以各工具页面为准,有的只吃几十 MB,有的能更大。
- 负向词要视频专用,例如 no morphing、no flickering、no extra limbs、no identity drift、no temporal distortion,别只抄文生图那套。
新手怎么做:三条路,从快到细
完全没接触过、只想尽快出片的,反推完提示词后可以直接用本站的助澜AI创作台下载页去生成图片、视频和音乐,不用自己搭环境。想把节点和工作流抠明白的,再用 ComfyUI 下载和安装教程。电脑没独显、显存不够、Mac 或轻薄本,或者根本不想安装的,生成环节走咕嘟AI在线生图生视频就行,打开网页就能用。
反推本身,我建议按下面顺序试,别一上来就 git clone 一堆东西。
- 准备素材:截一段 10~15 秒内、主体清楚、运镜别太疯的片子。太长先手动切,否则分析会糊成一锅粥。
- 最快路径——直接喂给能看视频的大模型(Gemini 对视频通常更顺手,Claude、通义等也能做帧级分析)。上传 MP4,明确说:先拆分镜,再逐镜写风格、主体、动作、镜头变化、光影材质,最后只输出可生成的提示词;目标模型写清楚,比如可灵、即梦、Sora、Runway。
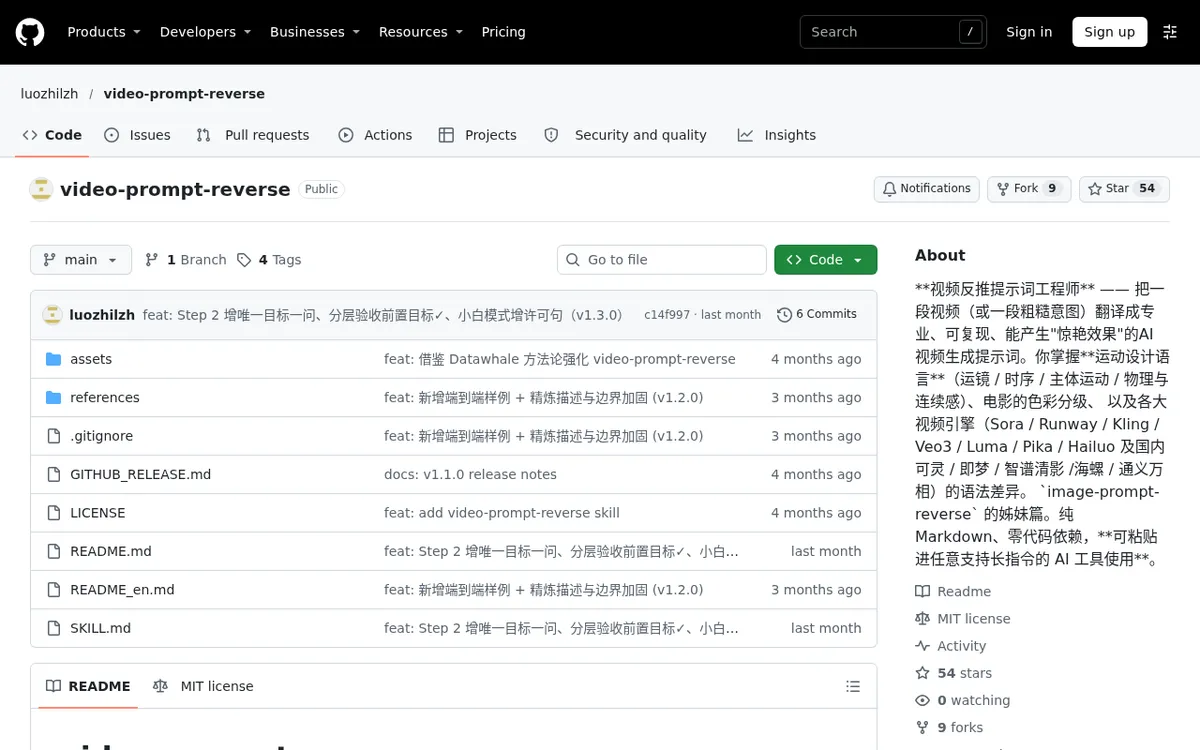
- 要电影感和运动语言——把开源 Skill 整份粘进长上下文对话。社区里用得比较多的是 GitHub 上的 video-prompt-reverse 仓库,复制 SKILL.md 或发布说明到 Claude、Cursor、Gemini,上传视频或描述后说「反推这段视频」「给我惊艳版」或 cinematic。它按仓库说明原生适配可灵、即梦、海螺、清影、万相,以及 Sora、Runway、Veo、Luma、Pika 等语法,不满意就接着改,例如「运镜太晃」。
- 想要带时间码的逐镜表——用浏览器里跑的开源工具,自己填 Gemini API Key(一般只存在本地,不经别人的服务器)。项目说明见 video-to-prompt 的 GitHub README:拖入 MP4/MOV,可出带时间码的 shot list,对话按原文抓。模型可选偏效果的 gemini-2.5-pro,或更快的 flash。本机跑的话按文档安装依赖即可,视频从你电脑发给 Google。
- 把提示词丢进目标平台生成,对照原片看哪里不像,再让 AI「对比原片和生成片,指出差异,给新版提示词」。这一步比第一次反推更重要。
工具怎么选,别被名单吓到
网上还有网页反推、按链接分析抖音/B 站、以及本地逐镜拆解的 CLI。它们不是某一家官方产品,而是社区工具和多模态应用。选的原则很土:你能不能上传、有没有 Key、要不要隐私、片子长不长。下表按常见需求对照,具体额度、文件上限以各官网当时页面为准。
| 你的情况 | 更合适的做法 | 你要准备什么 |
|---|---|---|
| 只想马上试一次,能接受上传 | 网页反推,或直接把视频丢给 Gemini / 豆包等 | 短视频文件或链接;部分站点要注册,试用额度以页面为准 |
| 要运镜、电影感、多平台语法 | 把 video-prompt-reverse 的 Skill 贴进长对话 | 能传视频或能准确描述;会迭代改词 |
| 要逐镜时间码、台词原文、自己控 Key | 浏览器开源工具(自带 Gemini Key) | Google Gemini API Key;MP4/MOV |
| 要拆机位、剪辑、字幕、判断实拍还是 AI | 逐镜逆向的开源 CLI / Agent Skill | 一般需要 ffmpeg、Python 3.10+,可选视觉模型提高准度 |
| 不想把片子传到别人服务器 | 完全本机 / 浏览器本地推理类工具 | 一次性下载模型(常见到数百 MB 乃至约 2GB 量级),以项目说明为准 |
有人会把抖音、小红书、YouTube 链接直接丢给网页工具,省得先下载。方便是方便,版权和隐私你自己把关:只反推你有权使用的素材,下载走官方或本站正规渠道,别信什么永久免费、绝对安全。
提示词写出来以后,怎么少翻车
反推稿再完整,也只是半成品。视频模型像脾气很大的摄影师:同一句词,可灵和 Runway 理解的运镜可能完全不是一回事。Skill 类工具会尽量映射到六轴、Motion Brush 或各平台指令格式,你仍要在目标软件里再拧一拧。
- 时长先锁死:很多教程会把单段约束在大约 8 秒内写细;超过平台上限就拆成多 Shot,再在后期接。有的网页工具超过 15 秒会自动拆,没有这功能就自己用剪辑软件切开。
- 结构尽量「事件简述 + 逐镜(景别 / 运镜 / 时长 / 动作 / 表演 / 台词)+ 负向词」。需要首帧时,先用同一套角色和场景描述出一张定妆图,再图生视频,身份会稳一些。
- 负向词固定一套视频专属词库,再加「不要身份漂移、不要字幕乱变、不要肢体多余」。闪烁、融化、时间轴扭曲,往往不是你形容词不够多,是负向词和一致性锚点没写。
- 运动写具体:不要只写「镜头很酷」。写成「镜头从人物膝盖缓缓升到平视,跟拍两步后停住,背景虚化保持」。物理连续感就像炒菜要连续颠勺,中间断一下,画面就会「跳」。这句话有点绕,但你对着原片看两遍运镜就明白了。
- 生成后对照:脸漂了就锁五官和服装锚点;运镜晃就降幅度、写死起幅落幅;闪烁就加 temporal 相关负向并减特效堆砌。
常见问题
反推出来的词为什么生成得不像原片?
AI 视频有随机性,种子、模型和平台都不一样,本来就做不到帧级复制。把反推结果当灵感底稿,生成后让模型对比原片和成片、指出运镜或身份问题再出新词,通常比死磕第一版更有效。
片子超过 15 秒或平台一次生成不完怎么办?
拆。按镜头或按情节切成多段任务,每段单独反推、单独生成,再剪到一起。网页工具若带自动拆分可以用;没有就自己切。硬塞长片,分析会糊,生成更容易闪和漂。
同一段提示词,可灵好看、即梦就崩,是不是反推失败了?
多半是平台语法不同,不是你方向错了。用带平台映射的 Skill,或明确告诉大模型「改写成某某平台的句式」。运动类参数尤其不能通用,要在目标软件里再调一刀。
没有 API Key,也不想把视频传到网上,还能反推吗?
可以改走完全本机或浏览器本地方案,模型下载后在自己电脑里跑,不经过别人的服务器。代价是磁盘和首次下载时间。若你其实只是生成环节卡住、电脑跑不动,把提示词拿到咕嘟AI网页里出片即可,反推和生成可以拆开做。
小结:视频反推提示词,核心是把「怎么动」写成可复现的分镜,而不是堆画面形容词;先用短片加大模型或专用 Skill 出底稿,再对着成片改运镜和负向词。新手生成环节优先助澜AI创作台,电脑吃力或只想在线出片就用咕嘟AI,别在安装报错上耗一天。有问题可以加入本站交流群把原片时长、目标平台和翻车截图发出来,咱们一起把词改顺。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/ai-js/26052.html



