
MiniMax 2.7开源吗?官方信息和本地使用方式介绍
本文目录
大家好,我是SD中文网的站长小庞。MiniMax 2.7(官方名称 MiniMax-M2.7)已经放出模型权重,个人自学、研究、教育和非商业自托管可以用,但许可证禁止未经授权的商业使用,所以更准确的说法是「开放权重」,不是能随便拿去卖服务的完全开源。官方 2026 年 3 月 18 日发布模型,4 月 12 日把权重放到 Hugging Face 和 GitHub;本地想跑通,通常要多张高端显卡,家用电脑基本不够。
MiniMax 2.7 到底算不算真正开源?
权重能下、能自己托管,这一点没骗人。2026 年 4 月 12 日,官方把模型放到了 Hugging Face 上的 MiniMax-M2.7 仓库,GitHub 上也有对应项目。很多人一听开源就以为能直接接进自己的产品里收费,这回可不行。
许可证全称是 MiniMax M2.7 Non-Commercial License。你可以把它理解成:菜谱公开了,你在家做饭、学校做实验都行;开饭店卖同款菜,得先写信拿到书面授权。非商业用途大致按偏宽松的条款免费允许;任何商业用途(付费服务、公司内部商用部署、把衍生模型拿去赚钱)都要提前联系 api@minimax.io 申请,主题写 “M2.7 licensing”。获批后还要在界面或文档里显著标注 “Built with MiniMax M2.7”。完整条文以 GitHub 上的官方 LICENSE 原文 为准,别只看别人转述。
| 用途 | 能不能直接用 |
|---|---|
| 个人自托管、研究、学术、教育、非营利、实验 | 可以,按非商业许可免费使用 |
| 付费 API、对外卖服务、内部商业部署、衍生品商业化 | 不行,必须先拿到书面授权 |
社区里对这套许可争议不小,不少人明确把它叫 open weights,而不是传统意义上的开源。个人玩、写论文,一般没问题;想上线收费,先把授权这件事办完再动手。
官方发了什么,模型本身有多大?
MiniMax-M2.7 属于 M2 系列的稀疏 MoE 模型。MoE 有点像一家公司雇了好多专家,每个问题只叫其中几个人来开会,不是全员打卡。公开资料里,总参数大约 229B 到 230B,每个 token 大约激活 10B(激活率大约 4.3%),62 层,256 个本地专家、每个 token 激活 8 个。上下文长度大约 20 万 token(不同来源写成 196K 到 205K)。它是文本模型,没有原生的图像或视频输入,别拿它当出图、出视频的 Checkpoint 用。
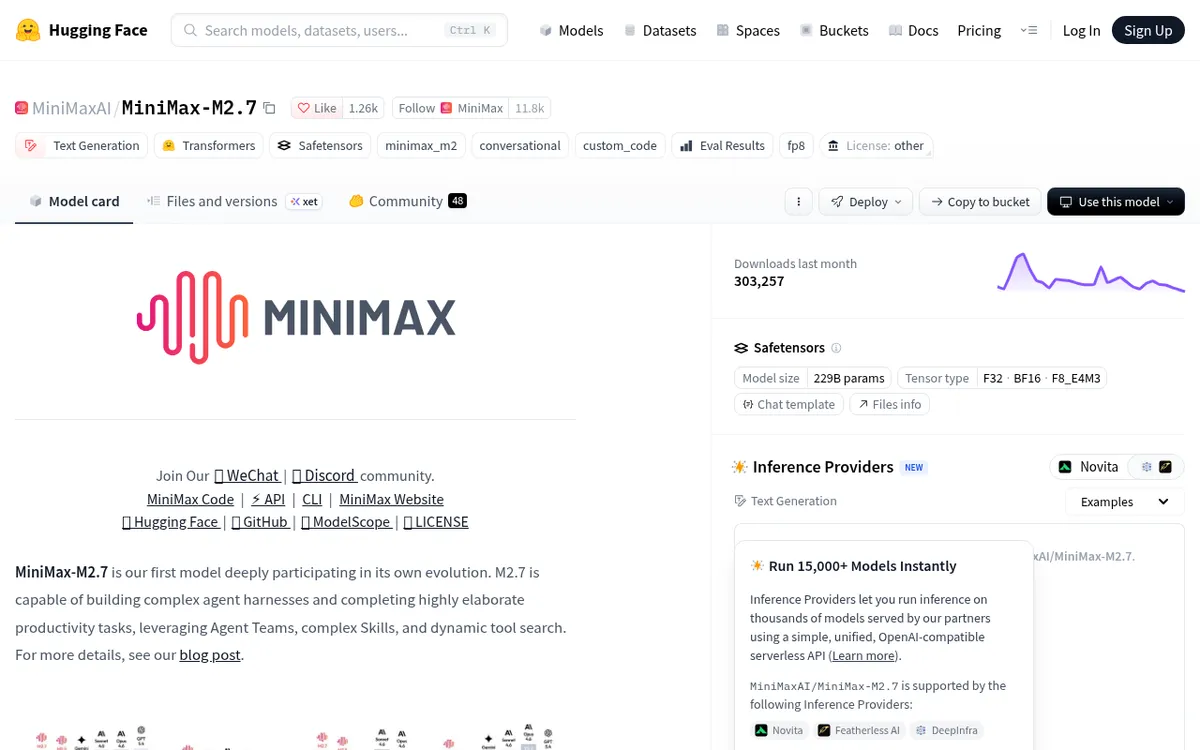
官方把它定位成深度参与自身演化的智能体模型,强调自我进化、Agent Teams、复杂 Skills 和动态工具搜索,适合搭比较重的 agent harness、做高难度生产力任务。权重格式常见是 safetensors。下载请走官方仓库,不要去路路不明的网盘捡所谓「破解包」。
截至 2026 年 11 月,MiniMax 已经推出 M3 系列。有平台从 2026 年 10 月 19 日起不再向新用户提供 M2.7,并计划在 2026 年 11 月 18 日彻底关掉 M2.7 的 API。云端接口会过期,本地权重一般还能继续下、继续自托管,但商用限制照旧。
本地怎么跑,电脑到底要什么配置?
先说结论:这不是一张游戏卡就能玩的东西。完整 BF16/FP32 要数百 GB 显存;4-bit 量化大约也要 136 GB GPU 显存。显存就像书桌,模型是一整面墙的百科全书,桌子太小根本摊不开。社区和官方侧的实用建议,通常是至少 4 张 H100/H200 这一档;2 张 H200 被说成勉强。单卡 A30 只在个别低资源测试场景里出现过,不能当成日常推理配置。
| 精度 / 场景 | 显存量级 | 适不适合家用电脑 |
|---|---|---|
| 完整 BF16 / FP32 | 数百 GB | 不适合 |
| 4-bit 量化 | 约 136 GB GPU 显存 | 不适合,仍要多卡 |
| 常见实用部署 | 约 4 张 H100/H200 | 不适合,2 张 H200 也只是勉强 |
推理框架优先看这几个:SGLang 被官方和社区强烈推荐,性能通常最好;vLLM 有比较完整的 Day-0 支持;Transformers 也能跑,效率一般。后训练和强化学习一侧,NVIDIA NeMo 有支持。用 vLLM 时,通常要开张量并行、专家并行,并指定 MiniMax M2 的 tool-call 解析器和 reasoning 解析器,同时打开 trust-remote-code。工具调用或思考格式对不上,多半是解析器没设对,而不是模型「坏了」。
- 先确认用途是非商业,并读完官方 LICENSE。
- 从 Hugging Face 官方仓库拉取 MiniMax-M2.7 权重,预留足够磁盘(完整权重很大,量化版也不是几 GB 能打发的)。
- 按机器选 SGLang 或 vLLM,多卡打开张量并行和专家并行。
- 需要工具调用时,务必加上对应的 minimax_m2 解析器,不要套别的模型的模板。
- 显存仍不够就改用 FP8 / 4-bit,或等社区更激进的量化;不要指望一张 4060、4090 硬上完整模型。
本地部署的话推荐 SGLang,性能最好,vLLM 也行,Transformers 也能跑不过效率一般。硬件这块说实话劝退的,4-bit 量化也要一百多 GB 显存,普通玩家基本没戏。后期社区出现过更狠的量化(包括 1-bit),能把门槛再往下压一点,稳定性和效果要以你实际测到的为准。
普通用户该怎么选,跑不动怎么办?
先把模型分清楚:MiniMax 2.7 是文本智能体,不是用来出海报、短视频或写歌的。你要是完全没接触过本地 AI,只想尽快做出图片、视频或音乐,别往这个 2300 亿参数的大家伙上撞。本站更建议直接用 助澜AI创作台的下载和介绍页:模型和运行环境不用自己搭,装好就能在本机做图、做带声音的视频和做音乐,适合怕折腾的新手。
想自己搭节点、第一时间跟新模型,再考虑 ComfyUI 官方桌面版的安装说明。ComfyUI 像积木,自由度高,但要花时间学连线。秋叶 WebUI 只适合已经习惯那套界面和插件的老用户,更新慢,较新的模型一般还是得去 ComfyUI。
没有 N 卡、显存不够、Mac 轻薄本、或者只想打开网页就出图出视频,别跟 MiniMax 2.7 的显存数字较劲。可以用 咕嘟AI 在线生图生视频,不用显卡、不用安装,手机和电脑打开网页就能用。云端 API 若已逐步下线 M2.7,低用量时租高配多卡自己托管也不一定更划算,先算电费和机器钱再决定。
- 只想出图、出视频、做音乐:优先助澜AI创作台,打开就能做。
- 想自己搭工作流、追新模型:选 ComfyUI,别一上来就上 2.7 这种多卡文本模型。
- 电脑跑不动、不想装环境:用咕嘟AI在线做。
- 明确要本地跑 MiniMax 2.7:先过许可证,再准备多卡和量化方案,下载只走官方仓库。
常见问题
个人学习和科研能免费用吗?
可以。非商业场景(个人自托管、研究、学术、教育、实验、非营利)按官方非商业许可允许使用。商用必须先拿到书面授权,并按要求标注来源,不要默认「开源就能上线收费」。
一张 RTX 4090 或 4060 Ti 能不能本地跑?
按目前公开的显存数字,完整精度和 4-bit 量化都远超单张消费级显卡。家用卡用来跑这个模型不现实,请改量化多卡、云主机,或直接换更适合你电脑的创作方式,比如助澜AI创作台或咕嘟AI。
官方 API 是不是很快就不能用了?
截至 2026 年 11 月,已有平台从 10 月 19 日起停止向新用户提供 M2.7,并计划 11 月 18 日完全退休 API。本地权重一般仍可下载使用,但接口可用性和价格请以当时官方公告为准。
它和 MiniMax 出视频、做音乐的模型是同一个吗?
不是。M2.7 是文本智能体;本站创作台里能用的视频、音乐能力是另一路模型。不要把「MiniMax」三个字混成一个软件,下载前看清仓库名称和许可证。
一句话:MiniMax 2.7 权重已经公开,个人研究能用,商用要授权,本地门槛极高。只想尽快做出片子和配乐,走助澜或在线工具更省事;真要自托管,先读 LICENSE、再备好多卡。有安装和选型问题,欢迎加入本站交流群继续聊,别一个人跟报错较劲。
原创文章,作者:SD中文网,如若转载,请注明出处:https://www.stablediffusion-cn.com/ai-js/25217.html



